 4 days ago
5
짐 노팅엄 HP ACS 수석부사장 겸 사업부 총괄 HP가 클라우드에서 처리하던 사내 인공지능(AI) 작업 40~50%를 워크스테이션과 AI 스테이션으로 옮겨 관련 비용을 45% 줄였다. 장비 투자비는 12개월 만에 회수했다. 에이전틱 AI가 확산되면서 토큰 비용이 급증하자, 데이터가 생성되는 현장 가까이에서 AI를 운용하는 '로컬 AI'로 무게중심을 옮긴 것이다. HP는 이같은 경험을 앞세워 반도체·의료·방송 등 국내 AI 시장을 공략한다. 짐 노팅엄 HP 어드밴스드 컴퓨트 솔루션(ACS) 부문 수석부사장은 “AI 어시스턴트 도입으로 업무 시간은 크게 줄었지만 토큰 소비가 계속 늘었다”며 “분석해보니 프런티어 모델 대신 보다 작은 모델로도 같은 품질을 낼 수 있었다”고 말했다. HP에 따르면 워크스테이션급 소형 모델을 사내 장비에서 구동하자 추론 속도는 빨라지고 토큰 사용 제한도 사라졌다. 사내 개발 조직도 프라이빗 클라우드 요금이 토큰 종량제로 바뀌자 로컬 장비를 들였다. 덕분에 개발자 30~80명이 제약없이 AI에이전트를 쓰고 있다. 노팅엄 수석부사장은 기업이 AI를 클라우드 밖에서 운용하려는 이유로 △데이터 프라이버시·주권 △저지연 △데이터 중력 △비용을 꼽았다. 수요가 가장 뚜렷한 곳은 제조 현장이다. 일례로 글로벌 완성차 A는 생산 라인에 AI 추론 장비를 설치하려 했다. 하지만, 그래픽처리장치(GPU)를 대거 탑재한 대형 워크스테이션은 발열과 소음 탓에 라인에 설치가 어려웠다. HP는 워크스테이션 GPU를 여러 장비가 나눠 쓰는 'Z부스트'를 제안했다. 대형 장비는 백오피스에, 라인에는 소형 장비만 배치해 GPU를 빌려 쓰는 방식이다. A는 개념검증(PoC)을 거쳐 전사 도입을 진행 중이다. 또, 다른 완성차 B는 Z부스트로 대형 렌더링 모델을 매번 다시 불러오는 과정을 없앴다. 그 결과, 설계 생산성을 570% 높이고 총소유비용(TCO)은 23% 줄였다. 퇴근 이후 쉬고 있는 워크스테이션 300여대로 매일 밤 약 1000건 AI 모델 미세조정을 수행해 클라우드 비용을 낮춘 고객사도 있다. 노팅엄 수석부사장은 “로컬과 클라우드 중 하나를 고르는 문제가 아니라 둘을 적재적소에 통합하는 하이브리드가 핵심”이라며 “고객이 가장 큰 가치를 낼 수 있는 곳에 귀한 토큰을 쓰도록 돕겠다”고 말했다. HP는 한국을 로컬 AI 수요가 빠르게 커질 시장으로 보고 있다. 반도체·자동차·조선처럼 설계·공정 데이터가 핵심...
Related

가업상속공제 놓고 여야 ‘충돌’…종부세 강화엔 나란히 제동
2 hours ago
3

[단독] 정부가 낸 법안에 정부가 ‘유감’…호텔·병원 가업상속 혜택 놓고 부처 충돌
3 hours ago
3

못 받은 돈만 3조, 더 빌려줄 수가…4대 은행 中企 ‘깡통대출’ 경고등
5 hours ago
5
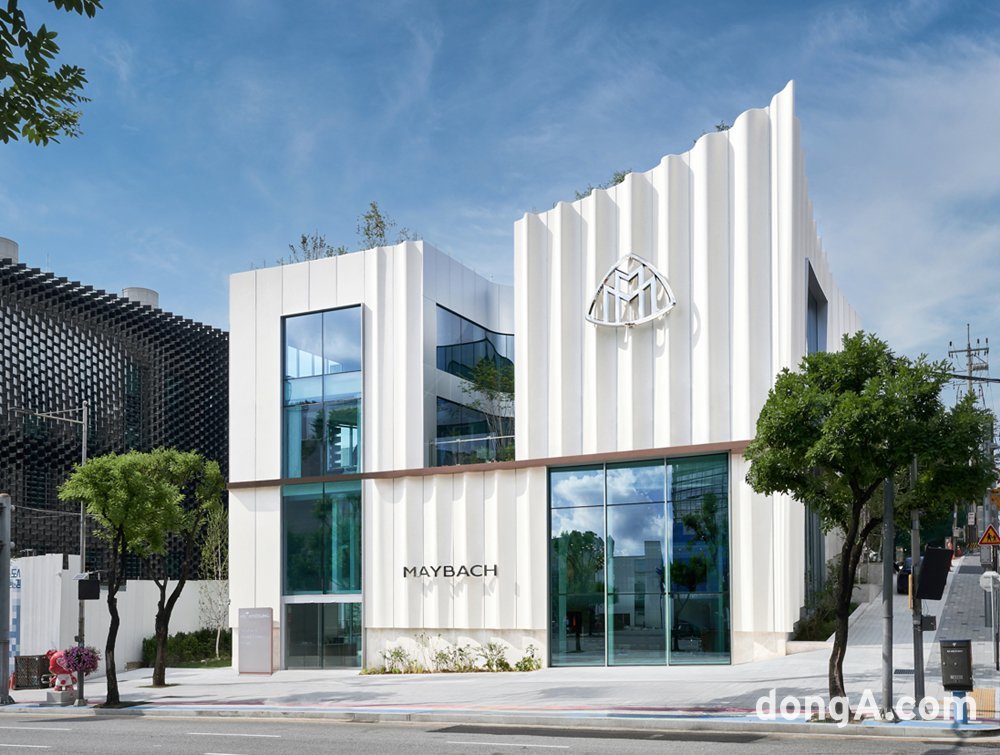
HS효성더클래스 직판제 안착… 마이바흐·S-클래스 판매 3개월 연속 증가
5 hours ago
5
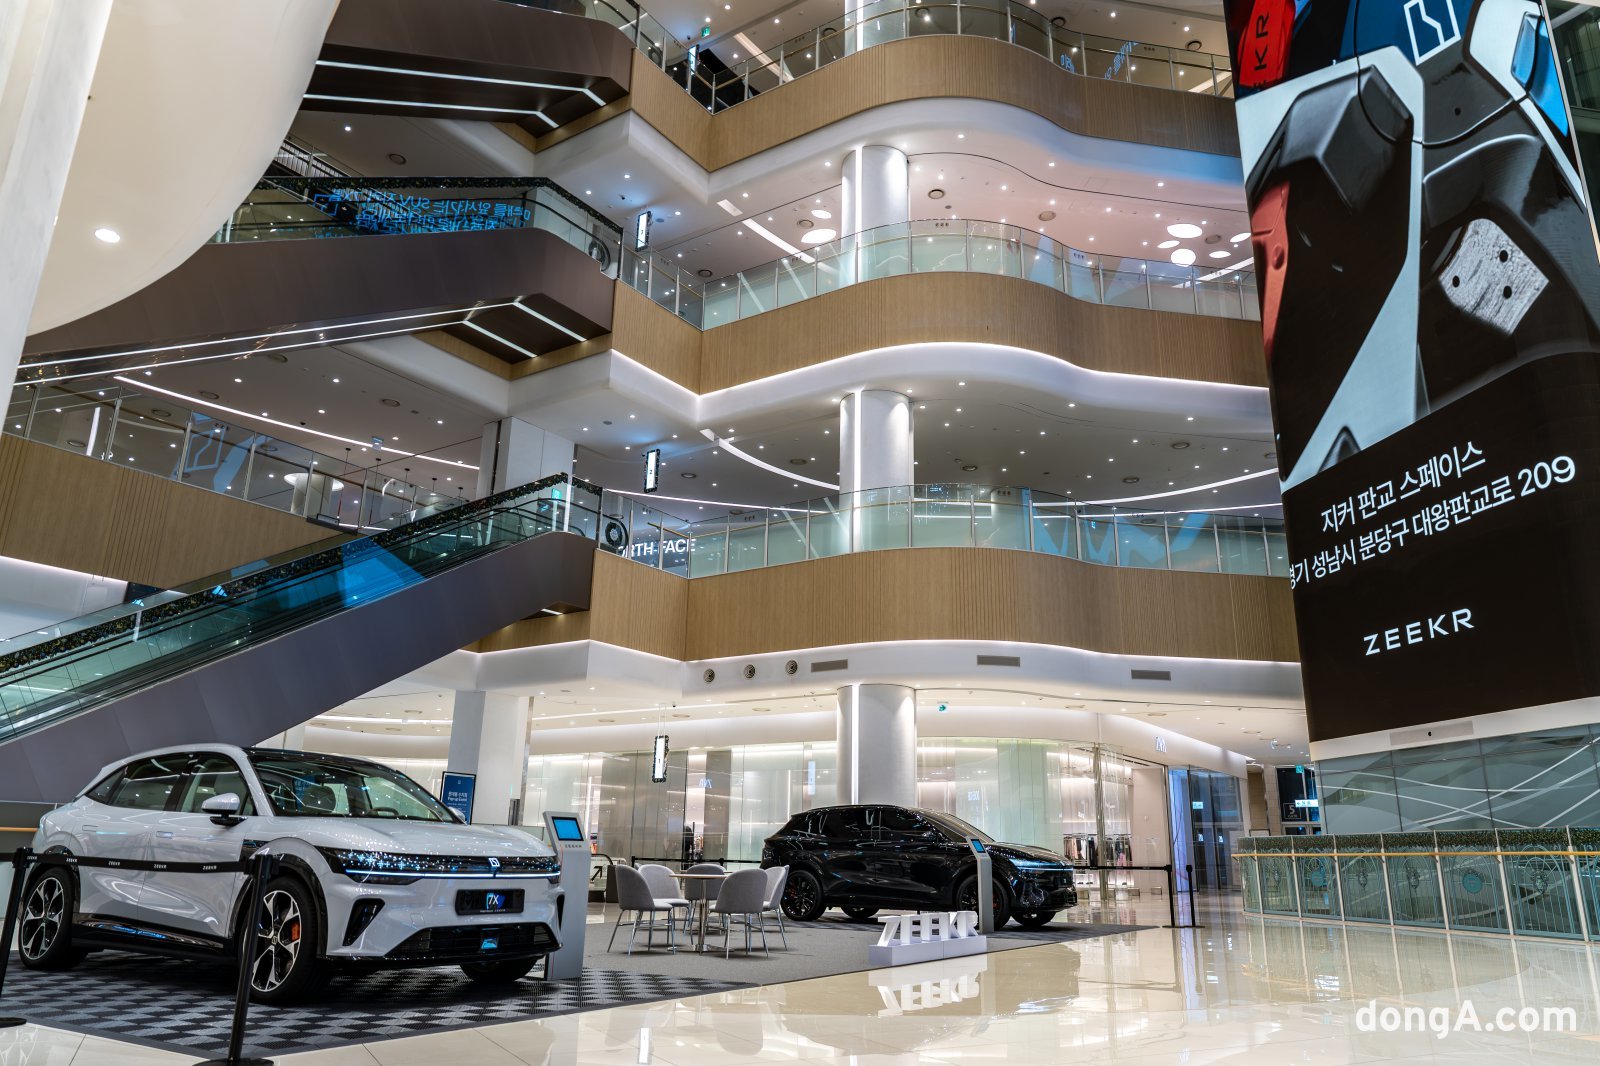
에이치모빌리티지케이, 롯데몰 수지점에 ‘지커 7X’ 투입
5 hours ago
2
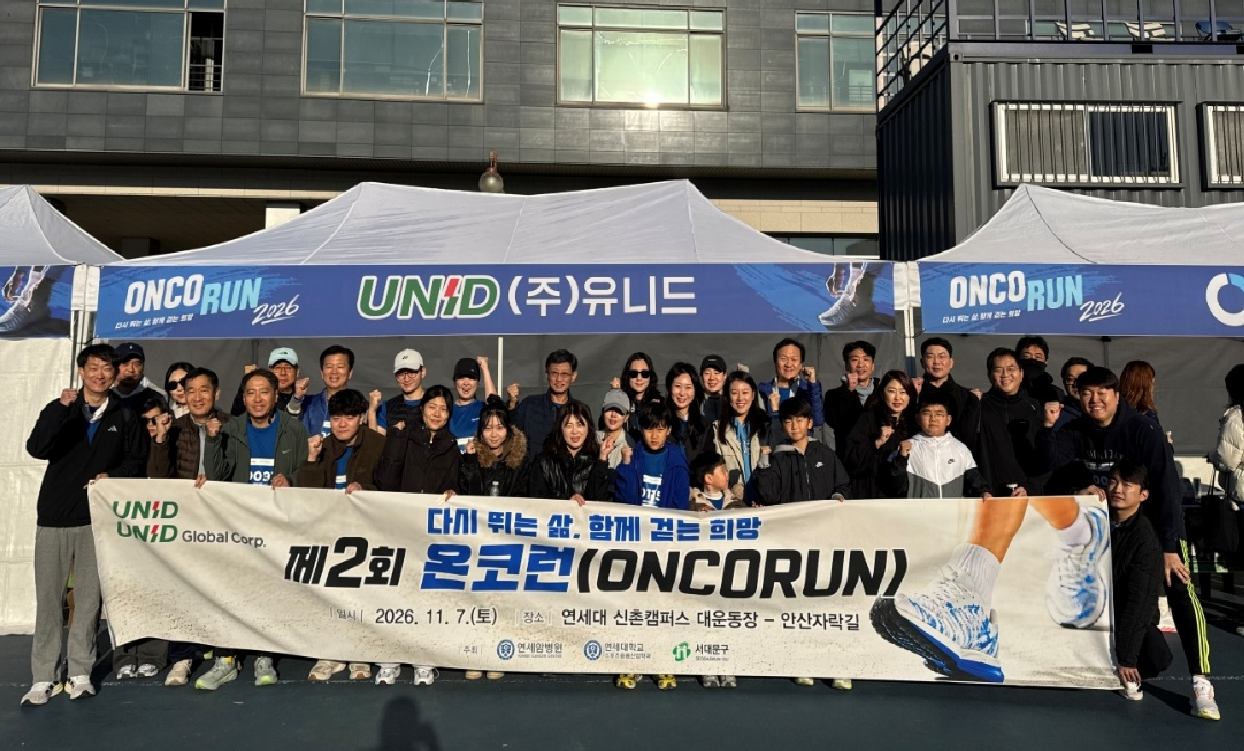
유니드, 암 생존자 일상 복귀 응원…‘온코런’ 2년 연속 후원
6 hours ago
4
젠슨 황 장녀 불참 이유 묻자 '동문서답'…장관·기업 일정 줄줄이 취소
7 hours ago
4
'경쟁 앱보다 싸게' 사실로…배민·쿠팡이츠 각 3000억 원대 과징금
7 hours ago
5
Popular
[美특징주]캠벨·제너럴밀스 등 강세…기술주 이탈해 소비재주로
3 weeks ago
574
3분기에 코스피 5.6조 팔아치운 개미들, 美주식은 10조 넘게 사들여
4 weeks ago
348

매경이 전하는 세상의 지식 (매-세-지, 10월 13일)
3 weeks ago
345

반도체팹이 바꾼 건설 수혜株… LS일렉·한양이엔지 재주목
4 weeks ago
344
클래식 문턱 낮춘 17세 아이히혼…“팔로어 상당수가 한국인 놀라워”
4 weeks ago
339

버그를 환자처럼, 코딩 에이전트를 의료팀처럼 다룬 5개월
4 weeks ago
338

“딸 숨져가던 21분 CCTV 사라져”…양재웅 병원 사망 유족, 경찰 초동수사 질타
3 weeks ago
313
Show GN: 나래 한글(나래팩) – AI 에이전트용 HWP/HWPX 편집·생성 CLI/스킬/템플릿 패키지...
3 weeks ago
312

국민연금이 美 아마존과 손잡은 까닭…“AI로 주식 분석할 것”
3 weeks ago
309
[단독]카카오TF, '카톡 선물하기' 스테이블코인 결제 추진
4 weeks ago
307
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
