
 6 days ago
21
잘 작동하던 프롬프트도 다른 지시나 문맥과 결합하거나 모델이 바뀌면 효과가 달라지므로, 문구를 다듬는 것만으로 에이전트의 신뢰성을 유지하기 어려움 같은 작업을 반복 실행해 실패를 찾고, 프롬프트를 바꾸기 전후의 동작을 테스트로 비교해야 실제로 개선됐는지 알 수 있음 실패 사례를 바탕으로 AI가 프롬프트를 자동 수정하게 하되, 최적화에 사용하지 않은 문제에서도 성능을 확인해 특정 테스트에만 맞춰지는 것을 막아야 함 브랜드 말투처럼 정답이 명확하지 않은 작업에서는 전문가가 좋은 답변과 나쁜 답변의 사례를 모아 평가 기준을 만드는 일이 프롬프트 작성보다 중요함 운영 중 발견한 실패를 테스트에 추가하고 다시 최적화하는 자기 교정 시스템을 남겨야 하며, 프롬프트는 그 과정에서 언제든 교체할 수 있는 결과물임 대상은 대화형 챗봇이 아니라 실제 작업을 수행하는 에이전트 핵심 대상은 소비자를 대신해 작업을 수행하는 에이전트이며, 출력과 결과가 대체로 주관적인 대화형 챗봇과 구분됨 에이전트를 만들고 다른 에이전트의 평가를 구축하는 작업은 프로그래밍의 즐거움을 되살릴 만큼 매력적이지만, 심리적으로 소모적이기도 함 에이전트로 에이전트를 실행하고 평가하는 일이 즐거운 동시에, 훌륭한 엔지니어링과 심리적 붕괴의 경계가 얇게 느껴지는 경험임 아직 무엇이 올바른 방법인지 확신하기 어려운 분야이므로, 완성된 정답보다는 실제 운영 경험을 비교할 필요가 있음 프롬프트가 텍스트라는 이유로 의식 없는 시스템에 의도적 관점(intentional stance) 을 적용하면, 그 텍스트가 인간의 의도와 같은 의미를 갖지 않는다는 본질을 놓치기 쉬움 작은 실패도 운영 규모에서는 드러남 LLM은 지시 준수, 진실한 답변, 작업 수행을 안정적으로 해내지 못하지만, 일상적인 사용에서는 꽤 신뢰할 만하다는 인상을 줄 수 있음 실제 사용자가 쓰는 에이전트를 운영하면 미묘한 실패뿐 아니라 단순한 실패도 드러남 구조화된 출력도 예외가 아님 Python 코드를 프롬프트에 자동으로 대응시키고 스키마를 따르게 할 수 있지만, 항상 준수하지는 않음 제목을 80자 이하로 반환하라고 해도 일부 요청에서는 JSON에 관한 자기 지시를 끝없이 반복하며 필드를 무의미한 내용으로 채움 가장 뛰어난 모델에서도 발생하며, 실패 비율은 입력의 구체적인 내용에 따라 달라져 지속적인 관찰이 필요함 한 사례에서는 필드 이름을 title에서 heading으로 변경하자 문제가 해결됐지만, 이 수정...
Related

일본, 외국인 대상 규정 강화 추진
3 hours ago
1
Atlas - 코딩 에이전트를 위한 소스 관리 도구
3 hours ago
1
서로 돕기 위해 잠시 멈추지 않는다면, 우리는 무엇이 되는가?
3 hours ago
4
ASML, 2026년 유럽에서 “아무것도 팔지 못했다”고 밝혀
3 hours ago
2
DeepSeek Elastic Compute (DSec)
3 hours ago
3
Automattic, CEO 휴직 시도 무산 후 새 이사회 구성
3 hours ago
2
Show HN: Reladraw - 요소를 어디에 놓을지 직접 정하는 다이어그램 언어
5 hours ago
2
Show GN: 자조모임 BBS 무료 게시판/대화방
5 hours ago
4
Popular

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
3 weeks ago
73

제니, 드레스 입고 와이어 촬영도…아찔+강렬한 비하인드
4 weeks ago
62
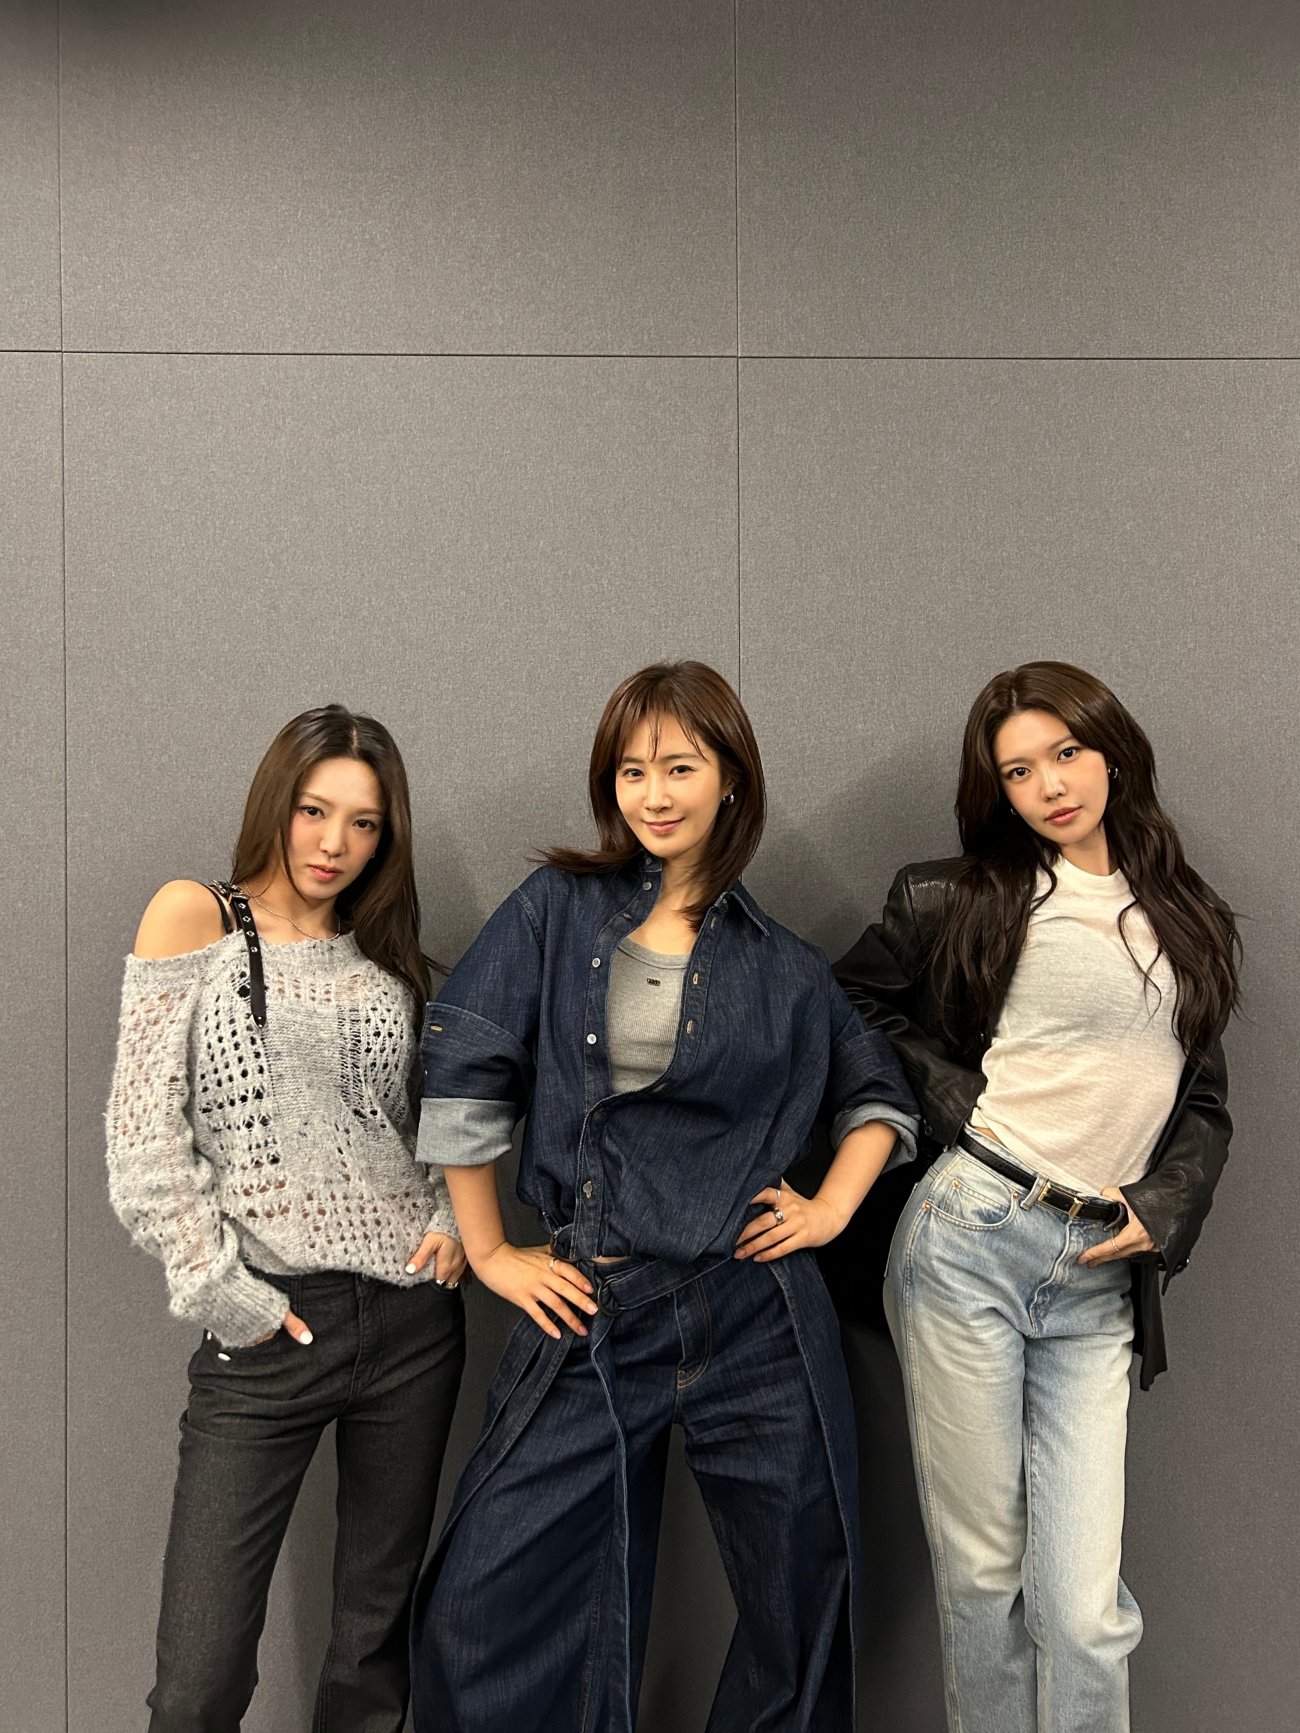
효리수, 그야말로 ‘화제의 신인’ 효연·유리·수영 K팝 새 판 짠다
3 weeks ago
50
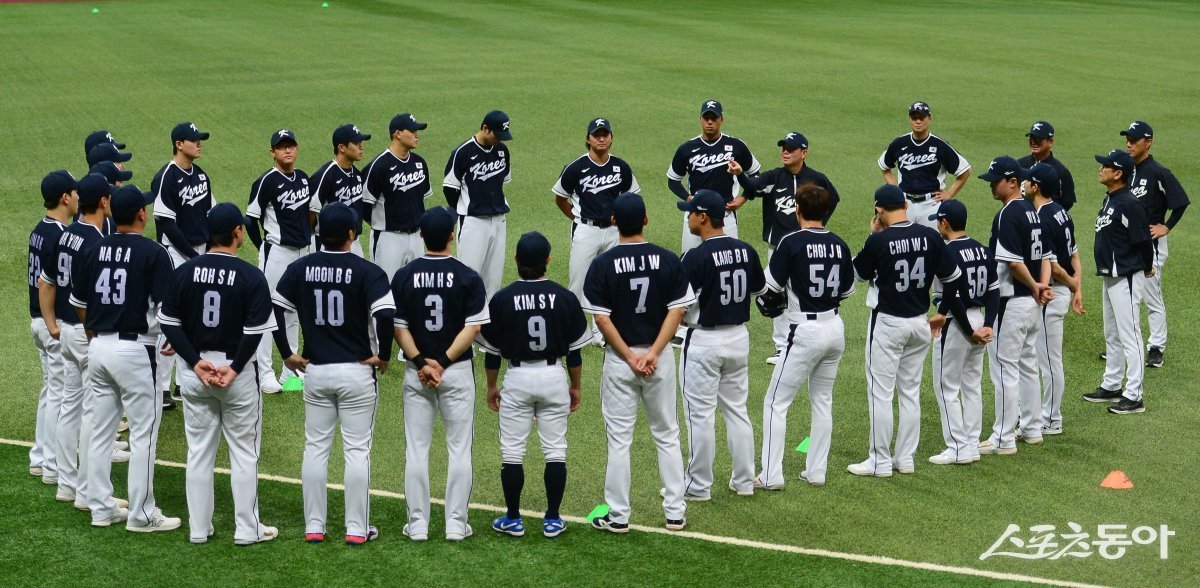
‘아시아 프로야구 최강팀 가리자’ 2026 APBC, 11월 12~15일 도쿄돔서 열린다
3 weeks ago
49
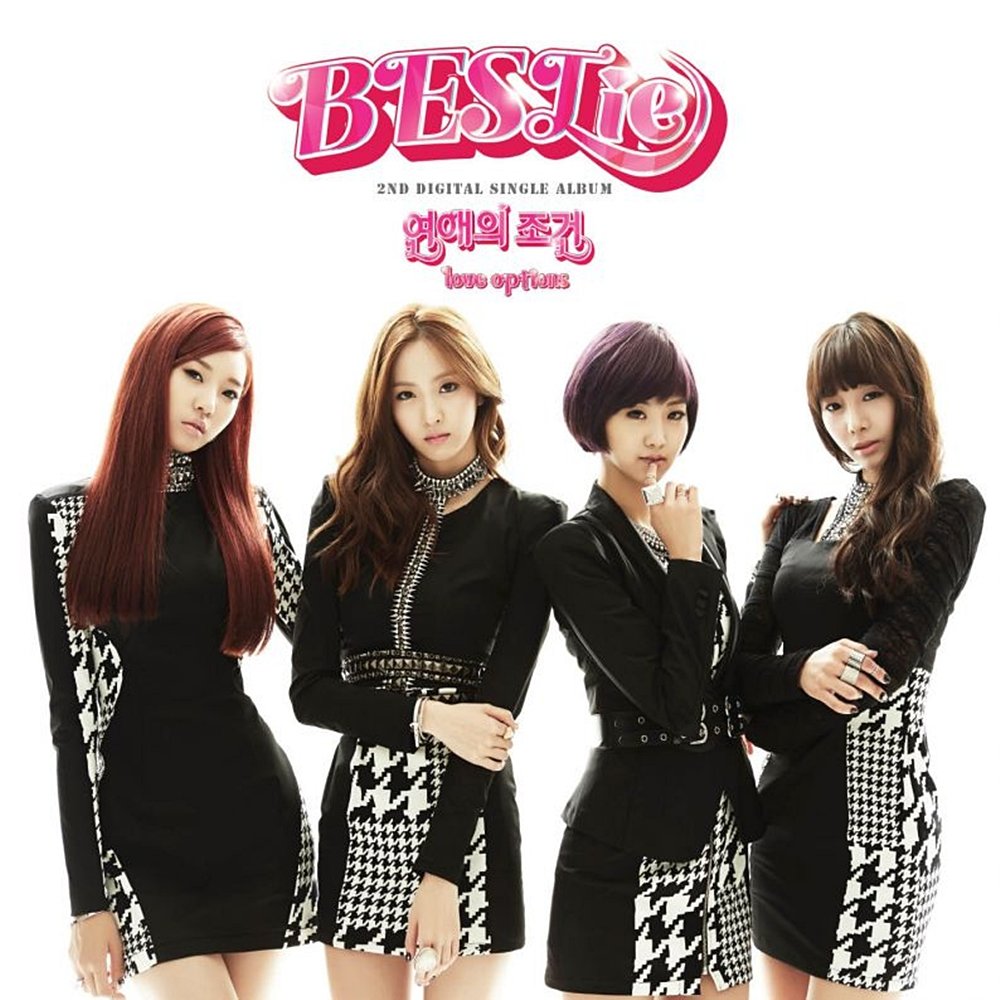
베스티 ‘연애의 조건’, 13년 만에 역주행…글로벌 차트까지 접수
2 weeks ago
48
[동아시론/김필남]AI 금지와 허용 사이, 대학이 지켜야 할 역할
4 weeks ago
48
금주 432시간..랄랄, 10kg 제대로 뺐다 "마운자로·위고비 NO"[스타이슈]
3 weeks ago
47
황재균, 폭염에 은퇴식 취소..온가족 총출동 "은퇴 선언도 취소해"[전참시]
4 weeks ago
47
[오늘과 내일/우경임]열 나는데 체온계 눈금만 고치는 수능 개편
4 weeks ago
47
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
