
 9 hours ago
5
GPU 한 장을 가상 머신 하나에 통째로 넘기는 대신, 호스트가 GPU를 유지하면서 여러 KVM 가상 머신이 함께 사용하도록 하는 실험적 프로젝트 모니터 없이 화면을 만들어 전송하는 헤드리스 스트리밍을 목표로, 게스트 안에서 GPU 렌더링, 합성, 인코딩을 수행하고 압축 영상만 외부로 전송 NVIDIA의 기존 사용자 모드 드라이버를 수정 없이 사용하며, 그래픽 API 호출을 하나씩 전달하는 대신 커널 드라이버 수준에서 요청을 연결해, 반복되는 렌더링 과정의 가상 머신 간 통신 비용을 줄임 RTX 3060 자체 시험에서 프레임 처리 시간이 약 2ms 이상인 부하는 직접 실행 대비 성능 차이가 2% 이내였으며, 가상 머신 4개의 동시 렌더링과 H.264 인코딩도 확인 다만 IOMMU 기반 하드웨어 격리는 제공하지 않으며, 서로 신뢰할 수 없는 사용자의 가상 머신을 운영하려면 VFIO나 vGPU 같은 별도 방식이 필요함 목표와 기존 방식의 제약 헤드리스 스트리밍에서는 호스트가 GPU를 계속 보유하고, 모니터 없는 게스트에서 게임/애플리케이션, Wayland 컴포지터, 하드웨어 인코더를 실행함 목표 파이프라인은 Vulkan/OpenGL 렌더링, 창 합성, CUDA 제로카피 가져오기, NVENC의 H.264/H.265 인코딩으로 이어짐 외부로 나가는 것은 프레임당 약 100KB의 압축 비트스트림이며, 이를 위해 버퍼 핸들, 펜스, CUDA 장치 포인터, NVENC 세션에 대한 실제 드라이버 수준 접근이 필요함 virtio-gpu + Venus의 API 수준 직렬화와 호스트 재실행은 이 용도에서 지연, CPU 비용, 게스트 인코딩 제약을 만듦 게임은 프레임당 1,000~5,000회의 드로 호출 외에도 바인딩, 디스크립터 갱신, 렌더 패스 전환을 수행함 60fps의 16.6ms 프레임 예산에서 직렬화에 1~3ms가 들면 GPU 작업 전에 6~18%를 소모함 직렬화, 전송, 재실행은 애플리케이션에 필요한 호스트 CPU를 사용함 호스트 소유 버퍼를 게스트 컴포지터가 보거나 가져올 수 없어, 게스트의 CUdeviceptr로 연결하기 어렵고 NVENC 사용에는 전체 CPU 읽기 및 복사가 필요함 DRM native context는 Intel/AMD에서 실제 Mesa 드라이버로 게스트 내부 명령 버퍼를 만들고 제출만 경계를 넘게 하며, 게스트 버퍼 소유권과 인코딩을 지원하지만 NVIDIA에는 없음 VFIO 패스스루는 네이티브 성능과...
Related

Alan Kay: Shannon은 잡음이 있는 채널을 다루는 방법을 제시했다 [영상]
48 minutes ago
1
Amiga 스크린 입문
51 minutes ago
1
과외 업체, 학부모에게 돈을 아끼고 “대신 AI를 쓰라”고 권고
54 minutes ago
1
Microsoft, Home/Code/Autopilot을 갖춘 새 Copilot 발표
1 hour ago
1
알렉산더 왕: 내가 Muse를 만드는 이유
1 hour ago
0
Show HN: Jev가 Pokémon Red를 플레이함
1 hour ago
0
늘 네트워크에 연결되어 있는 삶에 지쳤다
1 hour ago
0
ChatGPT와 Gemini가 가짜 고객센터 번호를 안내하도록 만드는 사기 수법
1 hour ago
0
Popular
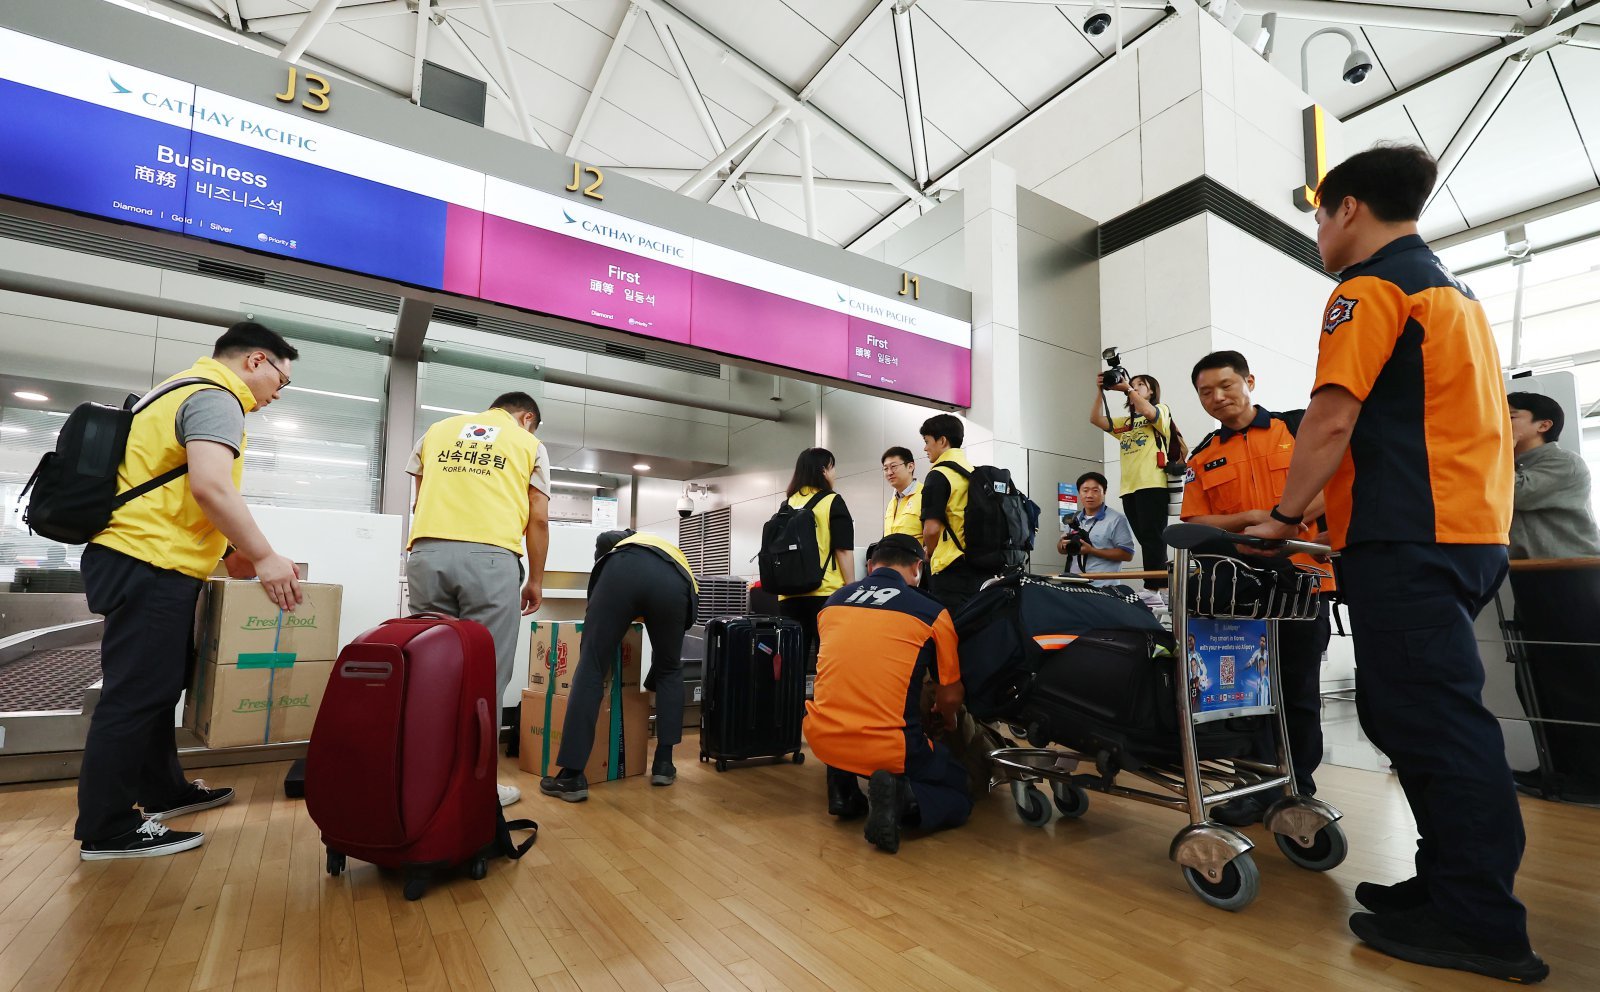
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
4 weeks ago
78

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
3 weeks ago
73

부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
4 weeks ago
69

‘실종 허위종결’ 파문에 고개 숙인 제주경찰청장…“모든 실종사건 재조사”
4 weeks ago
64

제니, 드레스 입고 와이어 촬영도…아찔+강렬한 비하인드
4 weeks ago
57

“복구 끝나기도 전에 또 비”…거제·통영 호우 피해지역 ‘긴장’
4 weeks ago
54

실종아동·입양인 개인정보 117만건 ‘싹’ 털렸다…유출 신고도 늦어
4 weeks ago
54
GR/IR Analysis in SAP S/4HANA Finance
4 weeks ago
51
남동발전 “네팔 발전소 상부시설 90% 이상 소실…직원 3명 수색”
4 weeks ago
51
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
