 2 hours ago
2
UTF-8000은 ASCII와 UTF-8을 포함하면서 임의 크기의 정수를 인코딩하도록 확장한 독립 제안으로, Unicode Consortium이 승인하거나 대표하는 표준은 아님 UTF-8의 선두 비트를 자기 동기화 비트와 길이 표시 비트로 분리하고, 길이 표시 비트를 연속 바이트에 걸쳐 배치해 인코딩 길이 제한을 없앰 자기 동기화, 길이 자체 식별, strcmp 정렬 순서를 유지하며, 새 예외 없이 ASCII와 2바이트 UTF-8의 기존 예외만 이어받음 여러 바이트로 이루어진 인코딩은 n바이트에 5n+1개 데이터 비트를 저장하며, 데이터 비율은 길이가 늘수록 62.5%에 수렴함 당장 필요한 확장은 아니라는 평가도 있으며, UCS-X와의 비교에서는 단순성과 대규모 인코딩 효율 사이의 절충이 드러남 제안의 범위와 확장 원리 UTF-8000, 또는 UTF-8K는 ASCII ⊆ UTF-8 ⊆ UTF-8000 관계를 목표로 하는 실험적 프로젝트임 현재 UTF-8의 4바이트 제한을 넘어 5, 6, 7바이트뿐 아니라 임의 길이까지 확장함 현재 UTF-8은 RFC 3629, 과거 6바이트 형식은 RFC 2044와 RFC 2279에 해당함 핵심은 UTF-8의 선두 비트를 자기 동기화(self-synchronization) 와 길이 자체 식별(self-punctuation) 이라는 독립 기능으로 나누는 것임 ASCII 바이트는 0, 여러 바이트 인코딩의 첫 바이트는 11, 이후 연속 바이트는 10으로 시작함 n바이트 인코딩의 길이는 n-2개의 1과 종결 비트 0으로 표시함 길이 표시 비트가 첫 바이트에 들어가지 않으면 연속 바이트의 10 접두부를 제외한 공간으로 이어짐 7바이트 인코딩은 11111110으로 시작하고, 8바이트부터는 11111111 100xxxxx …처럼 다음 바이트에도 길이 표시 비트가 들어감 9바이트는 11111111 1010xxxx …, 10바이트는 11111111 10110xxx …로 시작함 22바이트 예시는 11111111 10111111 10111111 10110xxx …이며, 별도 예외가 아니라 같은 규칙의 반복임 문서의 첫 바이트(first byte) 와 시작 바이트(start byte) 는 다른 개념임 첫 바이트는 인코딩마다 하나지만, 길이 표시 비트를 담는 시작 바이트는 여러 개일 수 있음 데이터 비트를 담는 바이트와 연속 바이트도 일치하지 않으며, 첫 바이트에 데이터가 들어가거나 연속 바이트가 ...
Related

Pirate Face - LLM 모델을 삭제로부터 구하는 서비스
2 hours ago
1
ZK-JPEG - 영지식 이미지 편집 및 압축
3 hours ago
1
Show GN: My Best Photo - 사진 후보를 비교 평가하고 선택 이유를 확인하는 서비스
3 hours ago
3
Step 5 Preview: 파레토 경계 확장
3 hours ago
3
채팅 기반 대규모 언어 모델은 심령술사 사기의 작동 방식을 재현한다
3 hours ago
4
Qwen-Image-2.1, 소형 고효율 통합 이미지 생성 모델
3 hours ago
2
어떤 이미지가 AI로 생성됐는지 구별할 수 있나요?
5 hours ago
2
Popular
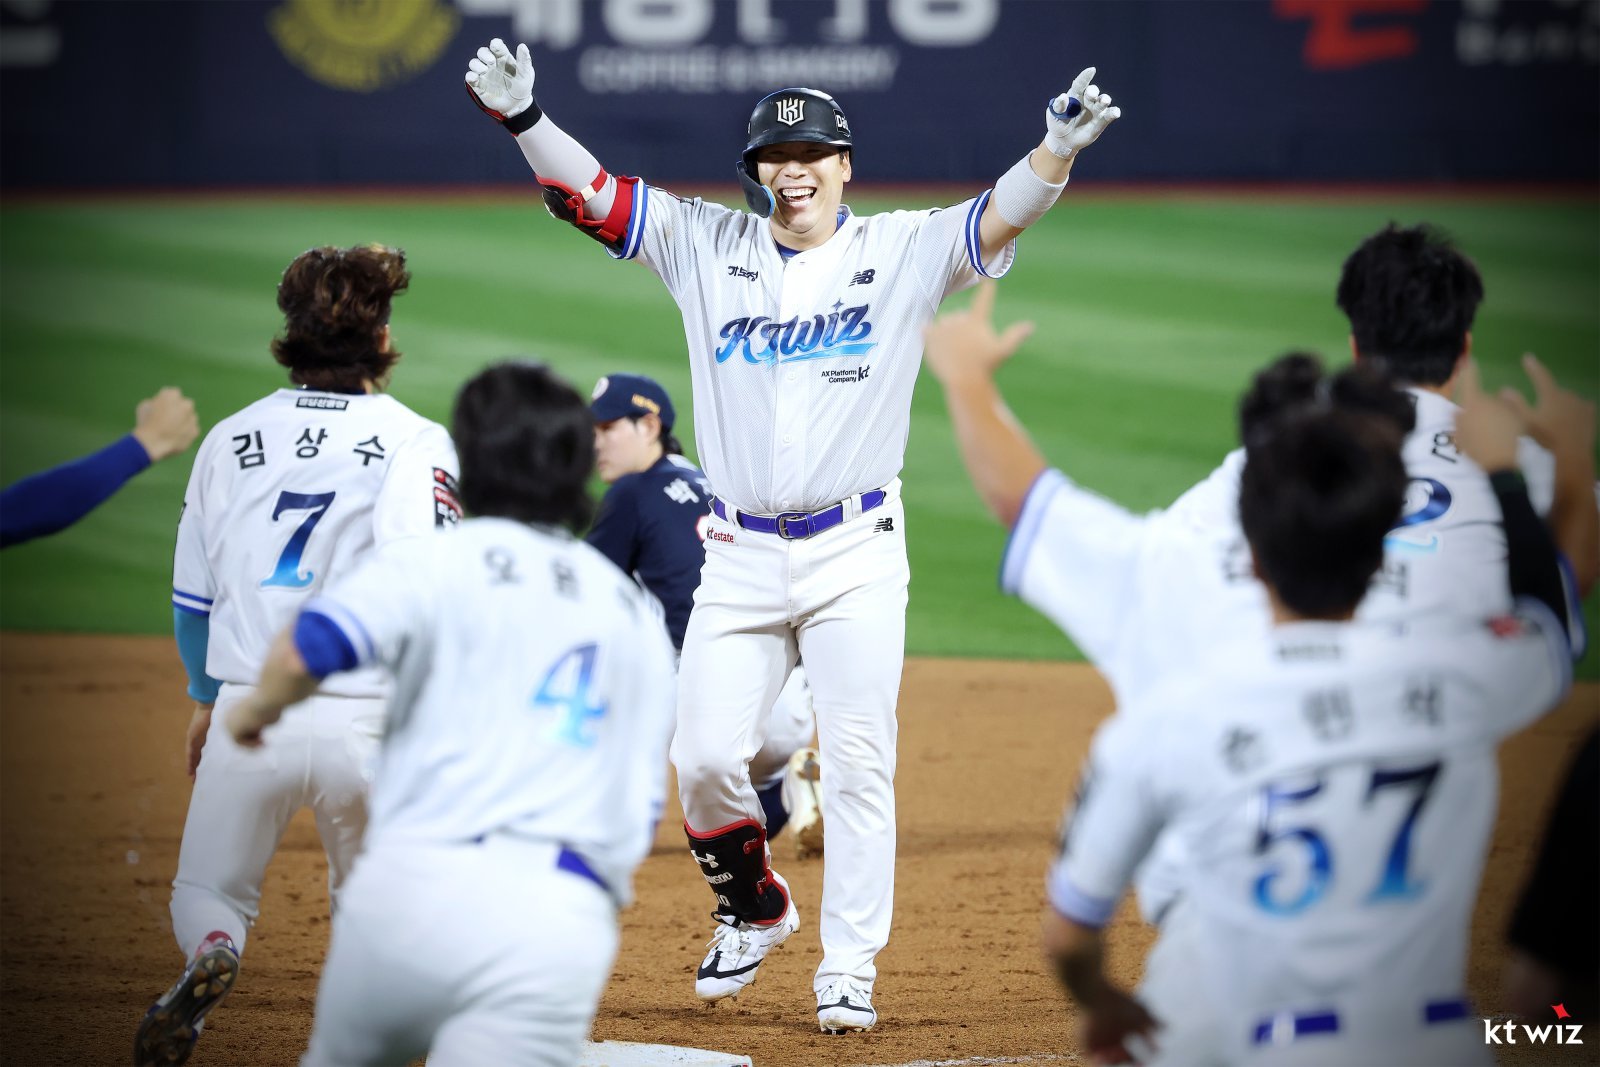
베테랑 김현수 끝내기안타…KT 선두 지켰다, 4년차 김정운은 데뷔 첫 승 감격 [SD 수원 스타]
3 weeks ago
67
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
3 weeks ago
66
한로로, 코르티스 ‘조롱 가사’ 논란 직접 등판…“좋은 뜻으로 받아들여”
3 weeks ago
66

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
2 weeks ago
63
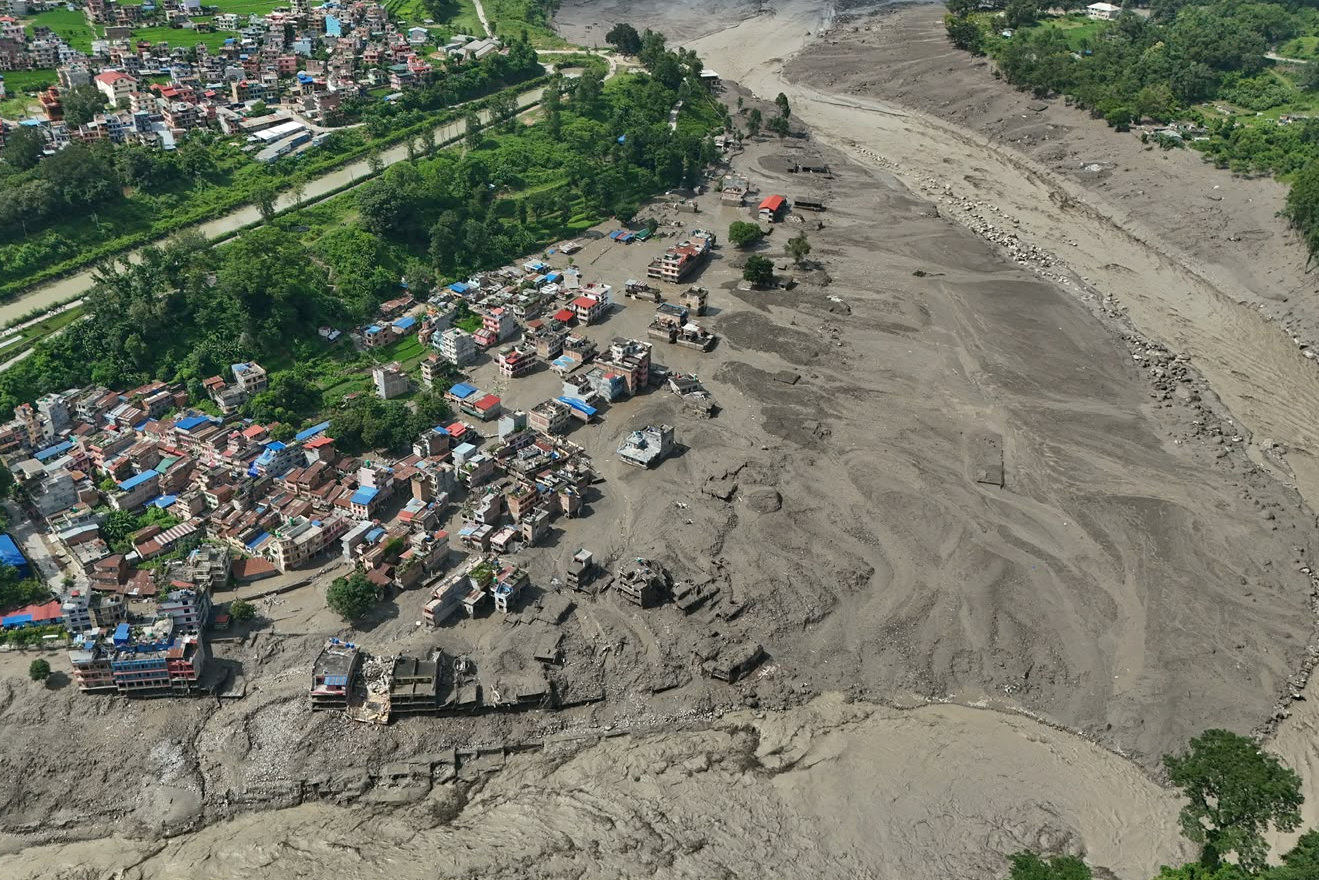
부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
3 weeks ago
61
Qwen 3.8-Flash-Next(125B a6B), 2026년 8월 26일 공개 예정
3 weeks ago
61
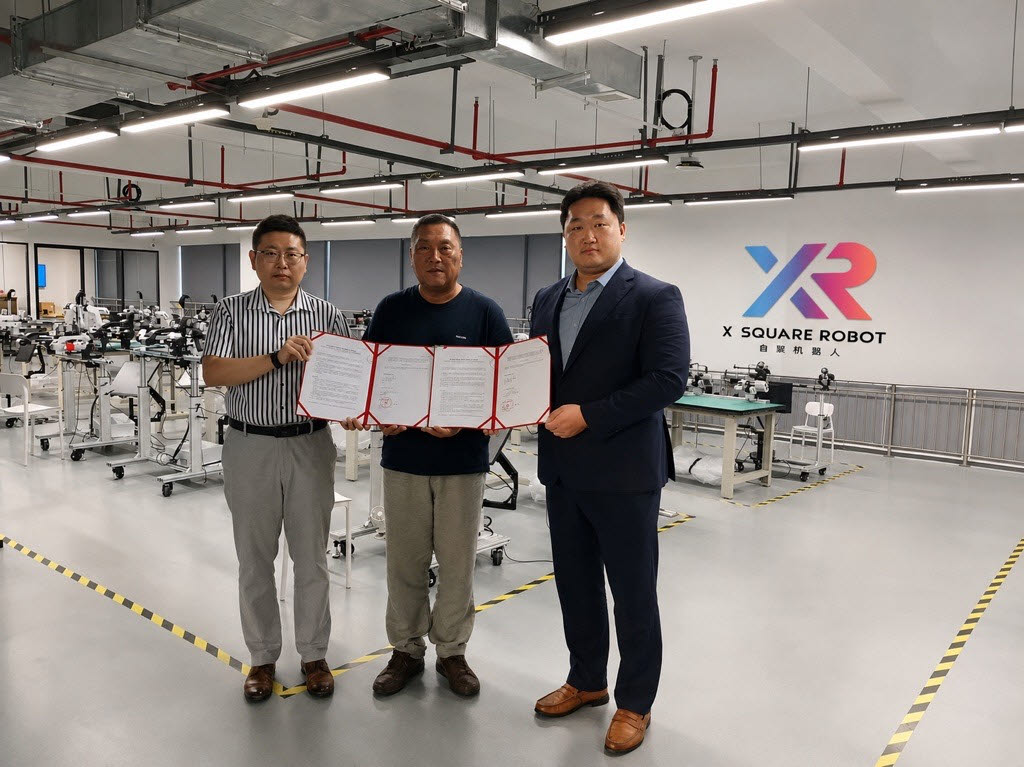
에브리봇, 中 피지컬 AI 기업 엑스스퀘어와 MOU…휴머노이드 사업 확대
3 weeks ago
60
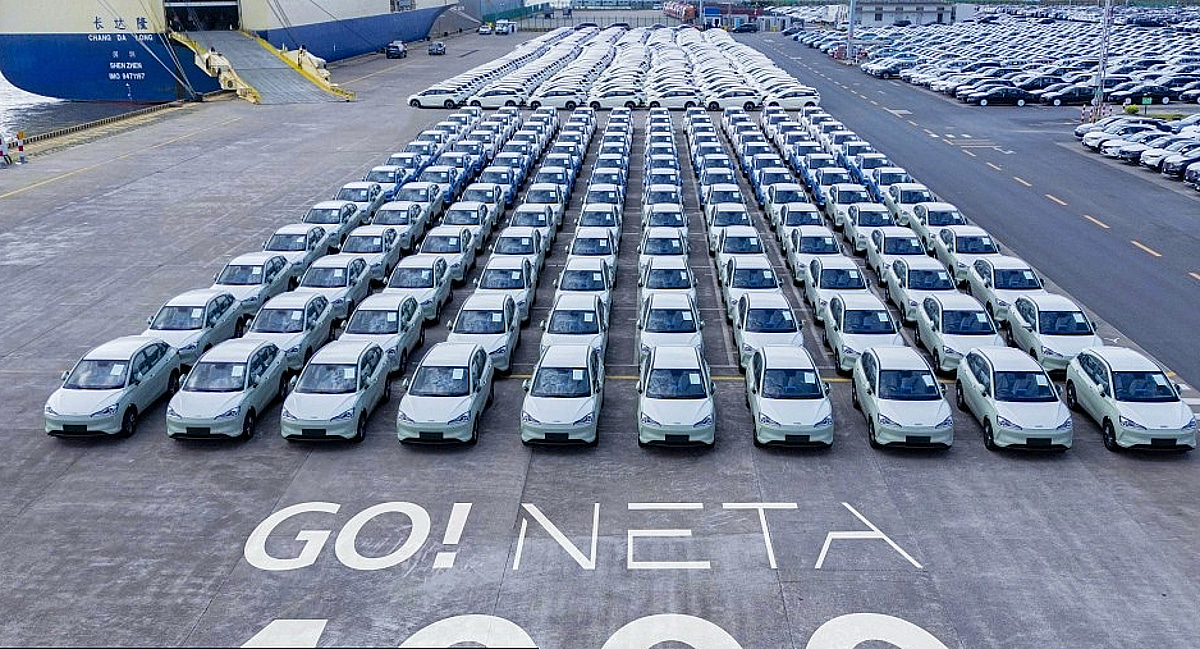
"파산 절차 돌입한 회사만 23곳"... 中 자동차 산업 재편의 서막 열리나
3 weeks ago
54
How to Reduce Capacity Requirements in SAP S/4HANA
3 weeks ago
52

오세훈 "강남 탄천에 1.3만가구"…'용산공원 임대주택'에 맞불
3 weeks ago
51
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
