
 6 days ago
12
3D 그래픽에 쓰이는 Three.js의 GPU 연산 기능으로 언어 모델을 실행하는 Three-LLM을 구현함. 별도 추론 서버 없이 브라우저에서 GPT-2, SmolLM2, Qwen, Phi 등을 구동 Hugging Face의 모델 파일을 직접 읽고, 행렬 곱과 어텐션 같은 연산을 TSL 컴퓨트 셰이더로 구성해 실행하며 모델별 사전 변환이나 별도 WebAssembly 바이너리가 필요 없음 텍스트를 토큰으로 바꾸고 다음 토큰을 선택하기까지의 과정을 구현하며, GPT-2의 기본 구조부터 Phi의 병렬 블록, Qwen의 고정 크기 순환 메모리까지 다룸 토큰 하나에 필요한 수백 개 GPU 연산의 명령 제출을 한 번으로 묶어 TinyStories는 약 4.7배, SmolLM2는 약 2.2배 빨라졌으며, 반복되는 프롬프트와 GPU 샘플링도 최적화함 5개 모델을 직접 실행하는 채팅 데모와 소스 코드를 공개함. 현재는 FP32 연산으로 메모리 부담이 커 모바일에는 작은 모델이 적합하며, FP16과 양자화 지원을 개선 중임 Three-LLM의 실행 방식과 지원 범위 Three-LLM은 Three.js와 WebGPU의 범용 연산 능력, 브라우저에서 실행하는 소형 언어 모델의 가능성을 시험하면서 만든 추론 라이브러리임 Three.js의 WebGPU 렌더러는 렌더링 외에도 스토리지 버퍼, 컴퓨트 디스패치, 워크그룹 메모리, 원자적 연산, GPU 데이터 읽기를 제공함 언어 모델 실행에는 순서가 정해진 수백 개 디스패치, 큰 행렬-벡터 곱, 축약 연산, 지속적인 어텐션/순환 상태, 토큰마다 반복되는 GPU와 JavaScript 간 상호작용이 필요함 브라우저에서 Hugging Face 설정, 토크나이저, SafeTensors 체크포인트를 읽고 Three.js Shading Language(TSL) 커널로 모델을 구성함 검증용 CPU 구현과 실제 사용을 위한 GPU 구현을 함께 제공함 GPT-2, Llama 계열, Gemma 3, Phi, Qwen3.5 아키텍처를 인식함 채팅 데모에서는 5개 체크포인트를 실행할 수 있음 TinyStories GPT-2 3M, GPT-2 124M, SmolLM2 135M, Qwen3.5 0.8B, Phi-1.5 1.3B를 제공함 FP32 확장 전 모델 파일 크기는 15MB~2.8GB이며, 모바일에서는 TinyStories나 SmolLM2 사용을 권장함 라이브러리는 일반적인 WebGPURenderer 와 cr...
Related

일본, 외국인 대상 규정 강화 추진
3 hours ago
1
Atlas - 코딩 에이전트를 위한 소스 관리 도구
3 hours ago
1
서로 돕기 위해 잠시 멈추지 않는다면, 우리는 무엇이 되는가?
3 hours ago
4
ASML, 2026년 유럽에서 “아무것도 팔지 못했다”고 밝혀
3 hours ago
2
DeepSeek Elastic Compute (DSec)
3 hours ago
3
Automattic, CEO 휴직 시도 무산 후 새 이사회 구성
3 hours ago
2
Show HN: Reladraw - 요소를 어디에 놓을지 직접 정하는 다이어그램 언어
5 hours ago
2
Show GN: 자조모임 BBS 무료 게시판/대화방
5 hours ago
4
Popular

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
3 weeks ago
73

제니, 드레스 입고 와이어 촬영도…아찔+강렬한 비하인드
4 weeks ago
62
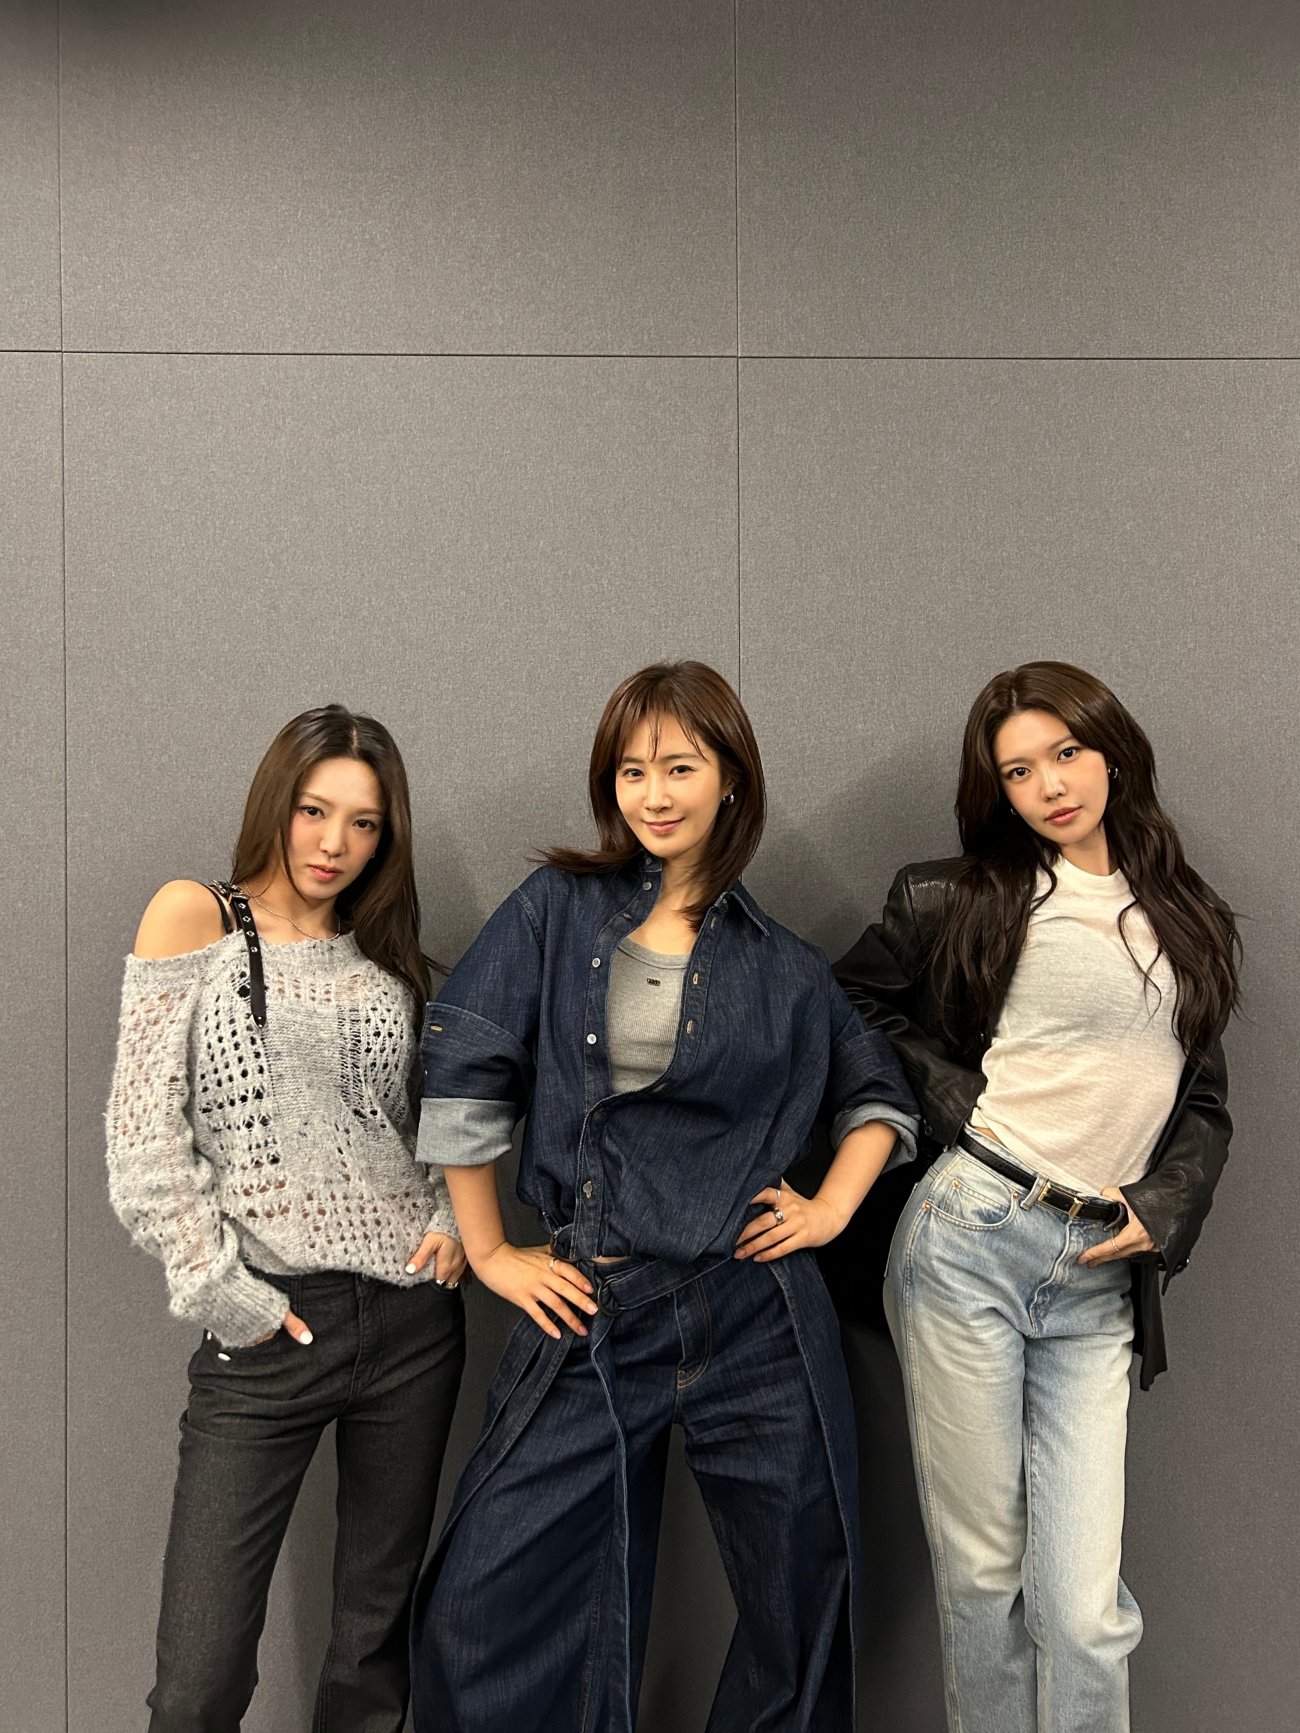
효리수, 그야말로 ‘화제의 신인’ 효연·유리·수영 K팝 새 판 짠다
3 weeks ago
50
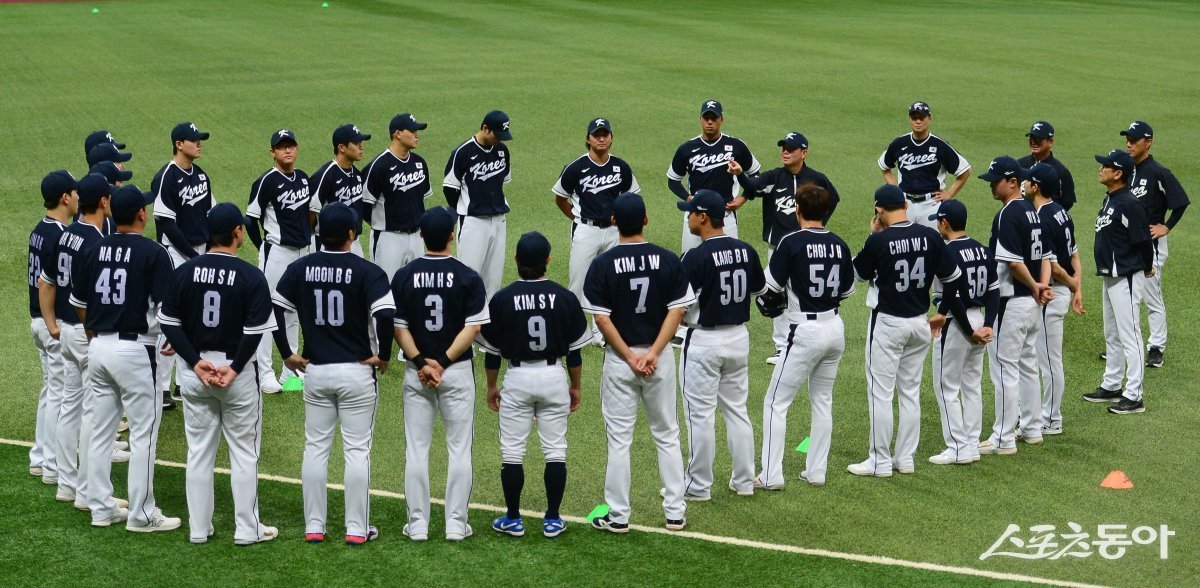
‘아시아 프로야구 최강팀 가리자’ 2026 APBC, 11월 12~15일 도쿄돔서 열린다
3 weeks ago
49
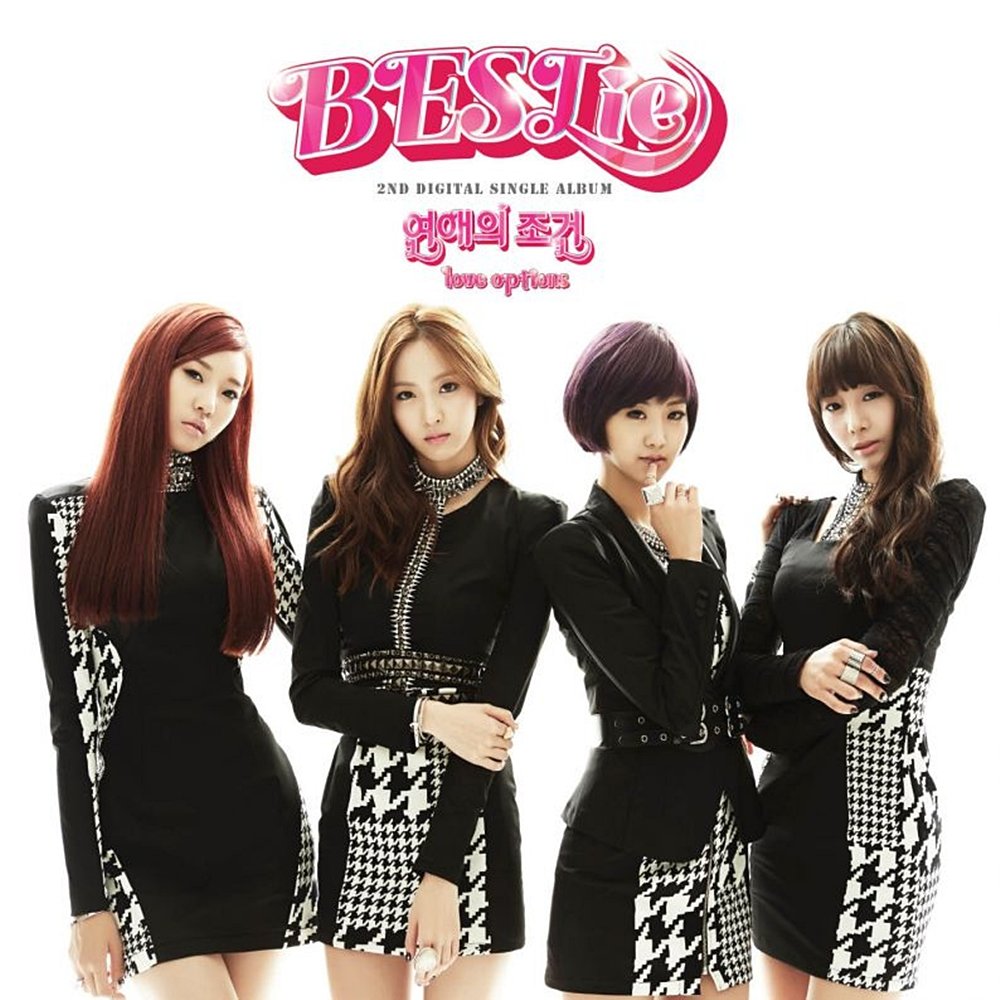
베스티 ‘연애의 조건’, 13년 만에 역주행…글로벌 차트까지 접수
2 weeks ago
48
[동아시론/김필남]AI 금지와 허용 사이, 대학이 지켜야 할 역할
4 weeks ago
48
금주 432시간..랄랄, 10kg 제대로 뺐다 "마운자로·위고비 NO"[스타이슈]
3 weeks ago
47
황재균, 폭염에 은퇴식 취소..온가족 총출동 "은퇴 선언도 취소해"[전참시]
4 weeks ago
47
[오늘과 내일/우경임]열 나는데 체온계 눈금만 고치는 수능 개편
4 weeks ago
47
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
