 2 hours ago
1
AI 사용 비용이 급격히 낮아지면서, 앞으로 토큰 수보다 품질과 접근성이 사용을 제약할 가능성이 있음 최첨단 모델의 토큰당 가격이 일관되게 내려가는 것은 아니지만, 과제 완료 비용은 크게 줄고 있으며 GPU와 추론 엔진의 효율 개선도 이어지고 있음 MoE와 Mamba 계열 아키텍처, 특화 분류 모델은 각각 연산량, 메모리 요구량, 특정 작업의 비용을 낮추지만 적용 환경과 기능에 제약이 있음 모델 실행 비용이 도구 실행 비용보다 낮아지면, AI를 독립 제품뿐 아니라 개발 도구와 컴퓨팅 인프라 내부에 넣는 방식이 더 매력적일 수 있음 저렴한 지능은 공급자의 품질 경쟁과 소프트웨어의 가치 기준을 바꿀 수 있으며, 사용자가 LLM에 직접 소프트웨어를 만들도록 요청하는 선택지도 넓혀 줌 저렴한 지능이 인프라가 되는 시나리오 머신러닝 지능을 사용하는 비용은 매년 여러 자릿수 규모로 하락하고 있으며, 둔화 조짐이 없다는 전제에서 저렴한 지능이 보편화될 수 있음 향후 1~2년 안에 LLM이 제품을 넘어 컴퓨팅 전반의 인프라에 통합될 가능성이 있음 3~6년 안에는 현재 최첨단 수준의 LLM을 일반적인 하드웨어에서 로컬로 실행할 가능성이 있음 가까운 시기에 사용량 자체보다 품질과 접근성이 AI 사용의 제약이 될 수 있음 여기서 AI는 LLM만 뜻하지 않으며, Jev처럼 텍스트를 생성하지 않지만 능력 면에서 비교할 만한 머신러닝 분류기도 포함함 개선 효과는 독점 모델, 호스팅되는 공개 가중치 모델, 로컬 모델에 동일하게 적용되지 않음 독점 모델의 예는 GPT-6 Astra, 공개 가중치 모델의 예는 GLM-5.3-flash이며, 공개 가중치 모델도 Z.ai 같은 서비스에서 호스팅할 수 있음 로컬 실행용 모델은 대체로 더 작으며, Muse Glimmer와 Qwen3 Coder가 그 예임 모든 AI에 영향을 주는 하드웨어와 모델 개선 GPU 전력 효율은 세대가 바뀔 때마다 지수적으로 개선되고 있음 Epoch AI 하드웨어 데이터의 시간 대비 GFLOP/J 추세는 효율이 약 2년마다 두 배가 되는 흐름을 보임 1960년대 무어의 법칙 이후 보기 어려웠던 수준의 효율 증가임 모델 가격에서 중요한 구분은 토큰당 비용과 과제당 비용임 토큰은 단어의 일부로, 단어 하나를 표현하는 데 대략 1.5토큰이 필요하며 공급자는 입력과 출력 토큰에 각각 요금을 부과함 최첨단 모델의 토큰당 가격은 일관되게 하락하지 않지만, 과제를 처음부터 끝까지 완료하는...
Related

Claude, CRISPR 유사 반복 서열을 가진 새로운 효소 시스템 발견
1 hour ago
0
Gemini 3.8 텍스트 음성 변환
2 hours ago
0
시애틀 시의회, 식료품 판매에서 감시 기반 가격 책정 금지 법안 가결
2 hours ago
0
이탈리아 의회, 원자력 에너지 복귀에 찬성 표결
2 hours ago
0
Jev 기반 자동 교정
3 hours ago
2
시의회 회의에서 Flock에 관해 발언한 여성, 체포돼 끌려나가
3 hours ago
6
Hacker News는 왜 그런가?
3 hours ago
2
GPT-6 Astra가 자동차를 운전할 능력을 갖추게 됨
4 hours ago
2
Popular
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
3 weeks ago
74
Qwen 3.8-Flash-Next(125B a6B), 2026년 8월 26일 공개 예정
4 weeks ago
73
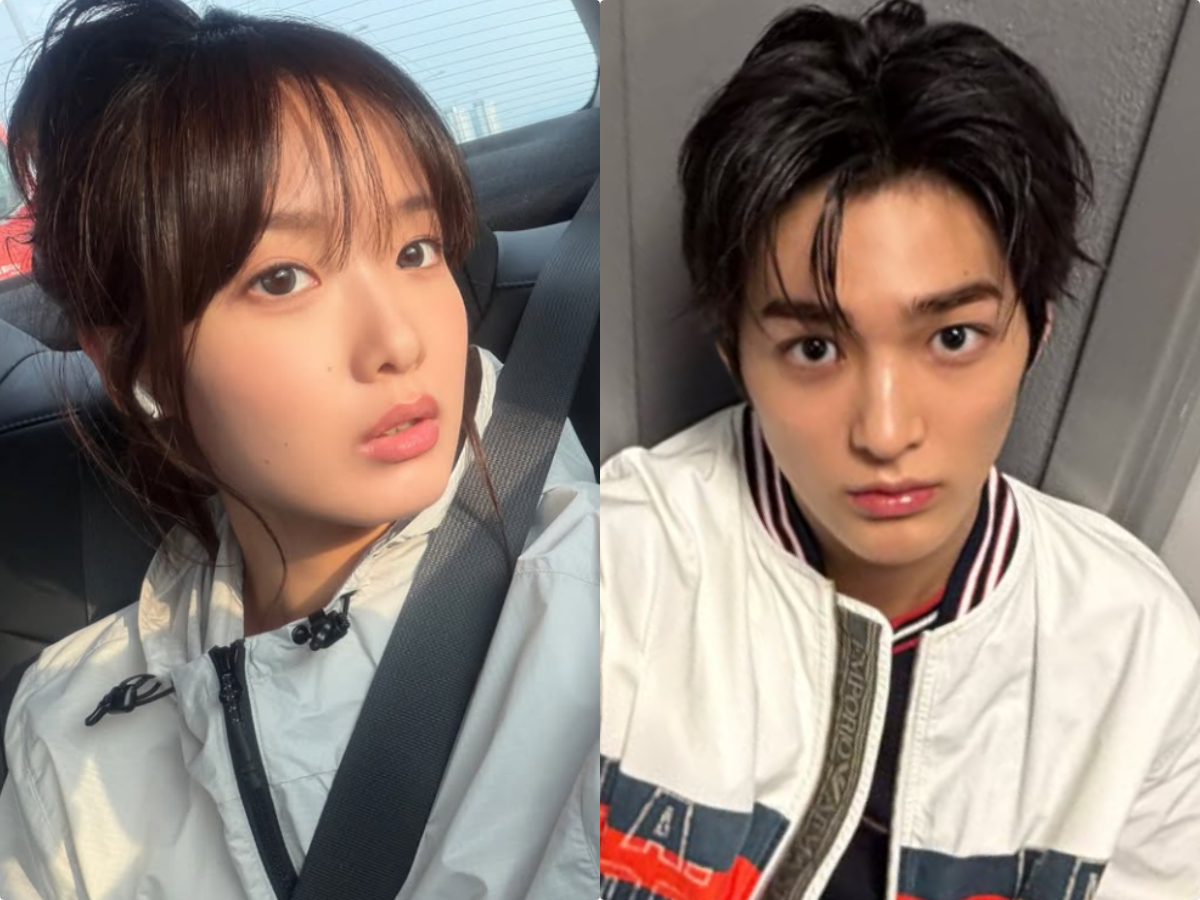
한로로, 코르티스 ‘조롱 가사’ 논란 직접 등판…“좋은 뜻으로 받아들여”
4 weeks ago
72

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
2 weeks ago
71
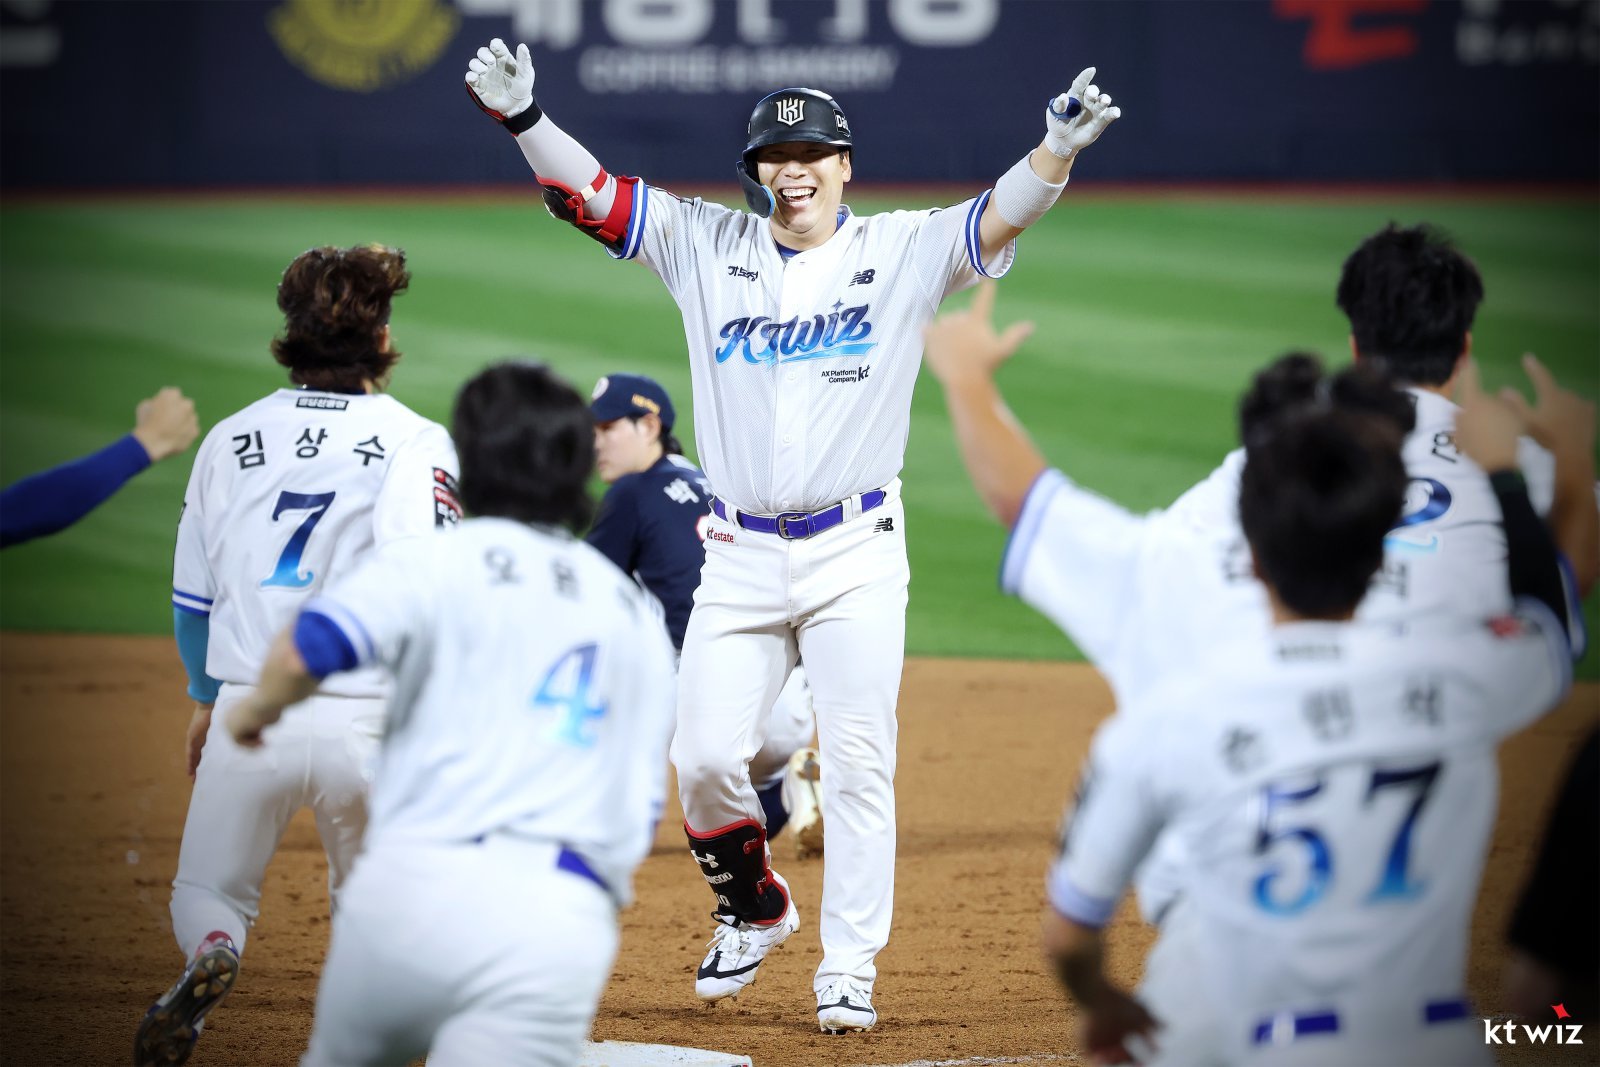
베테랑 김현수 끝내기안타…KT 선두 지켰다, 4년차 김정운은 데뷔 첫 승 감격 [SD 수원 스타]
4 weeks ago
71

부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
3 weeks ago
66
에브리봇, 中 피지컬 AI 기업 엑스스퀘어와 MOU…휴머노이드 사업 확대
4 weeks ago
66
"파산 절차 돌입한 회사만 23곳"... 中 자동차 산업 재편의 서막 열리나
4 weeks ago
63

오세훈 "강남 탄천에 1.3만가구"…'용산공원 임대주택'에 맞불
4 weeks ago
63

‘실종 허위종결’ 파문에 고개 숙인 제주경찰청장…“모든 실종사건 재조사”
3 weeks ago
60
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
