 1 week ago
21
Parquet는 같은 열의 값을 모아 저장해, 대규모 데이터에서 필요한 열만 빠르게 읽는 파일 형식. CSV처럼 모든 줄을 훑고 텍스트를 숫자로 변환하는 작업을 줄여 분석과 모델 학습에 유리 택시 운행 약 1,000만 건에서 평균 요금을 구하는 실험에서 CSV보다 파일 크기가 6분의 1이었고, 읽기 속도는 27배 빨랐음 반복되는 값은 사전과 반복 횟수, 적은 비트로 표현하고 그 결과를 다시 압축. 같은 데이터라도 압축 방식과 행 정렬 순서에 따라 파일 크기와 읽기 속도가 달라짐 행 그룹별 최솟값과 최댓값으로 조건에 맞지 않는 구간을 건너뜀. 자주 필터링하는 열로 정렬하면 효과가 커지고, 잘못된 값 몇 개가 범위를 넓혀 불필요한 읽기를 유발할 수도 있음 한 행씩 조회하거나 추가하는 서비스에는 행 지향 저장, 많은 행의 일부 열을 읽는 분석과 모델 학습에는 열 지향 저장이 적합. Parquet 선택도 실제 읽기와 쓰기 방식에 따라 판단할 문제 CSV와 Parquet의 읽기 성능 차이 택시 운행 약 1,000만 건의 평균 요금을 계산하는 함수는 거의 1GB인 CSV를 읽을 때 0.2초 미만이 걸렸음 같은 데이터를 담은 Parquet로 입력만 바꾸면 파일 크기는 6분의 1, 실행 시간은 7ms가 되어 27배 빨라짐 언어 모델이 이런 함수를 쉽게 작성할 수 있어도, 데이터를 어떤 형식으로 저장할지는 사람이 선택함 행 지향 저장은 CSV, JSON Lines, Avro처럼 테이블을 행별로 저장하고, 열 지향 저장은 Parquet, ORC, Feather처럼 열별로 저장함 예제 CSV의 한 줄에는 운행 한 건의 값 19개가 쉼표로 구분되어 있음 값의 길이가 일정하지 않아 요금의 위치도 매번 달라지므로, 읽기 도구는 모든 줄의 문자를 읽고 쉼표를 세어 요금을 찾아야 함 Parquet는 요금을 한곳에 모아 저장하므로 다른 열을 건너뛰고 요금 열만 읽을 수 있음 대부분의 집계, 필터링, 학습 작업은 많은 행에서 일부 열만 읽음 비교한 세 도구 중 CSV 읽기가 가장 빠른 것은 Polars였음 DuckDB는 Polars보다 3배 이상, pandas는 10배 이상 오래 걸렸음 각 도구의 Parquet 읽기를 가장 빠른 CSV 읽기와 비교했으며, pandas조차 Parquet의 요금 열을 Polars의 CSV 읽기보다 7배 빠르게 읽었음 세 도구 모두에서 속도가 개선되어 파일 형식 자체의 효과를 확인함 텍스트 파싱과 자료형 추론을 피...
Related

Oracle, AI 인프라 확충 위해 약 26조원 규모 신주와 채권 발행 계획 제출
1 hour ago
3
Show GN: 치이카와 닮은꼴 찾기
1 hour ago
1
MyGo - Go UI와 웹 프런트엔드로 데스크톱 앱을 만드는 오픈소스
1 hour ago
3
Postgres 19 출시가 늦어지는 건 AI 때문이다 - 버그 발견이 수정을 앞지르다
2 hours ago
3
BYD, 지난달 미국의 한 분기 전체보다 많은 전기차 판매
2 hours ago
1
내가 가장 좋아하는 노트북
3 hours ago
2
Ubuntu, 거의 3주째 Linux 제로데이 원격 코드 실행 취약점 패치 미출시
3 hours ago
5
OpenBSD용 GEFS(Good Enough File System) 개발 진전
4 hours ago
2
Popular

승부 가리기엔 11회가 모자랐다…KT, 연장 접전 끝 롯데와 2-2 무승부→매직넘버 2
4 weeks ago
492

“군대 안가” 자랑한 축구대표팀에…안철수 “군대가 혐오시설? 군면제 없애야”
4 weeks ago
485

[ET특징주]펩트론, 일라이릴리 기술평가 종료 소식에 하락세
3 weeks ago
483

[美특징주]캠벨·제너럴밀스 등 강세…기술주 이탈해 소비재주로
2 weeks ago
480

은행권 AI 연쇄해킹…공격서버에 ‘중국어 문자열’ 있었다는데
4 weeks ago
479
이효리, 잔고 10만원·찬물 샤워 '쉬었음 청년' 커플 사연에.."너무 마음 아파"[연애전쟁]
4 weeks ago
380
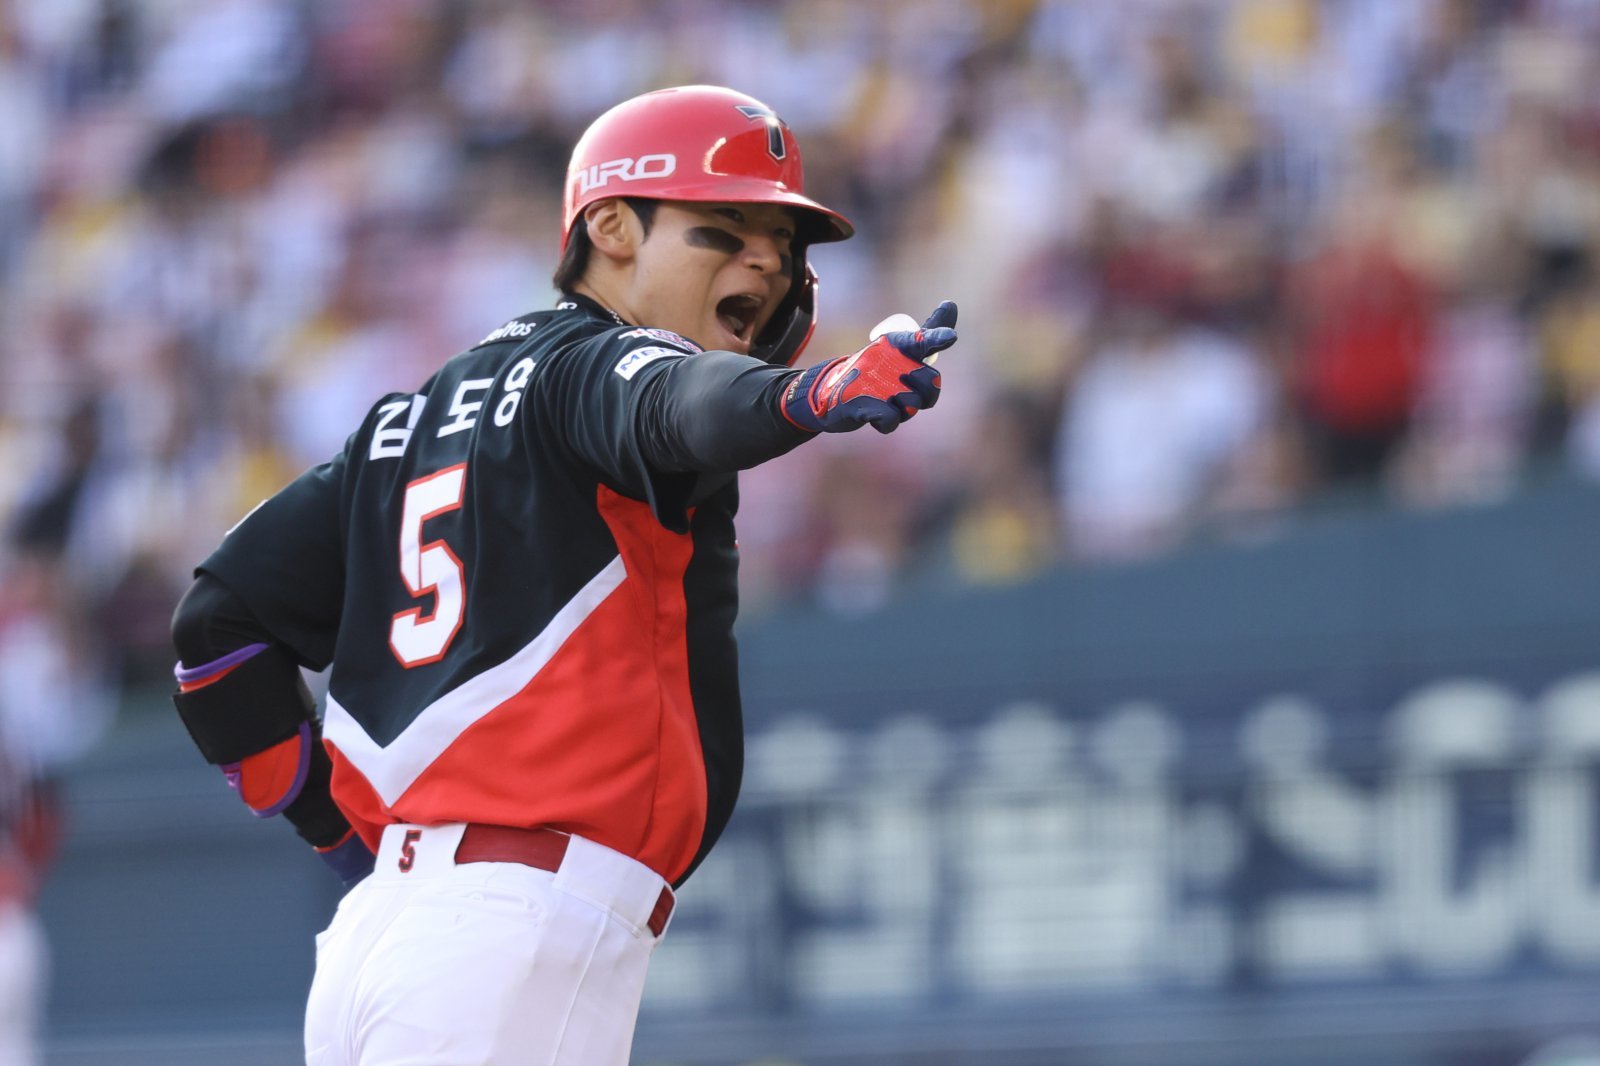
“왜 슈퍼스타인지 증명했다” 김도영, 9회초 역전 스리런포 작렬…KIA 3위 자리 지켰다
4 weeks ago
378
존슨앤존슨, 켄뷰 분사로 혁신 의약품 집중…목표가 상향-씨티
4 weeks ago
367
[美특징주]레나, 버크셔해서웨이가 지분 매입 소식에 상승
3 weeks ago
365
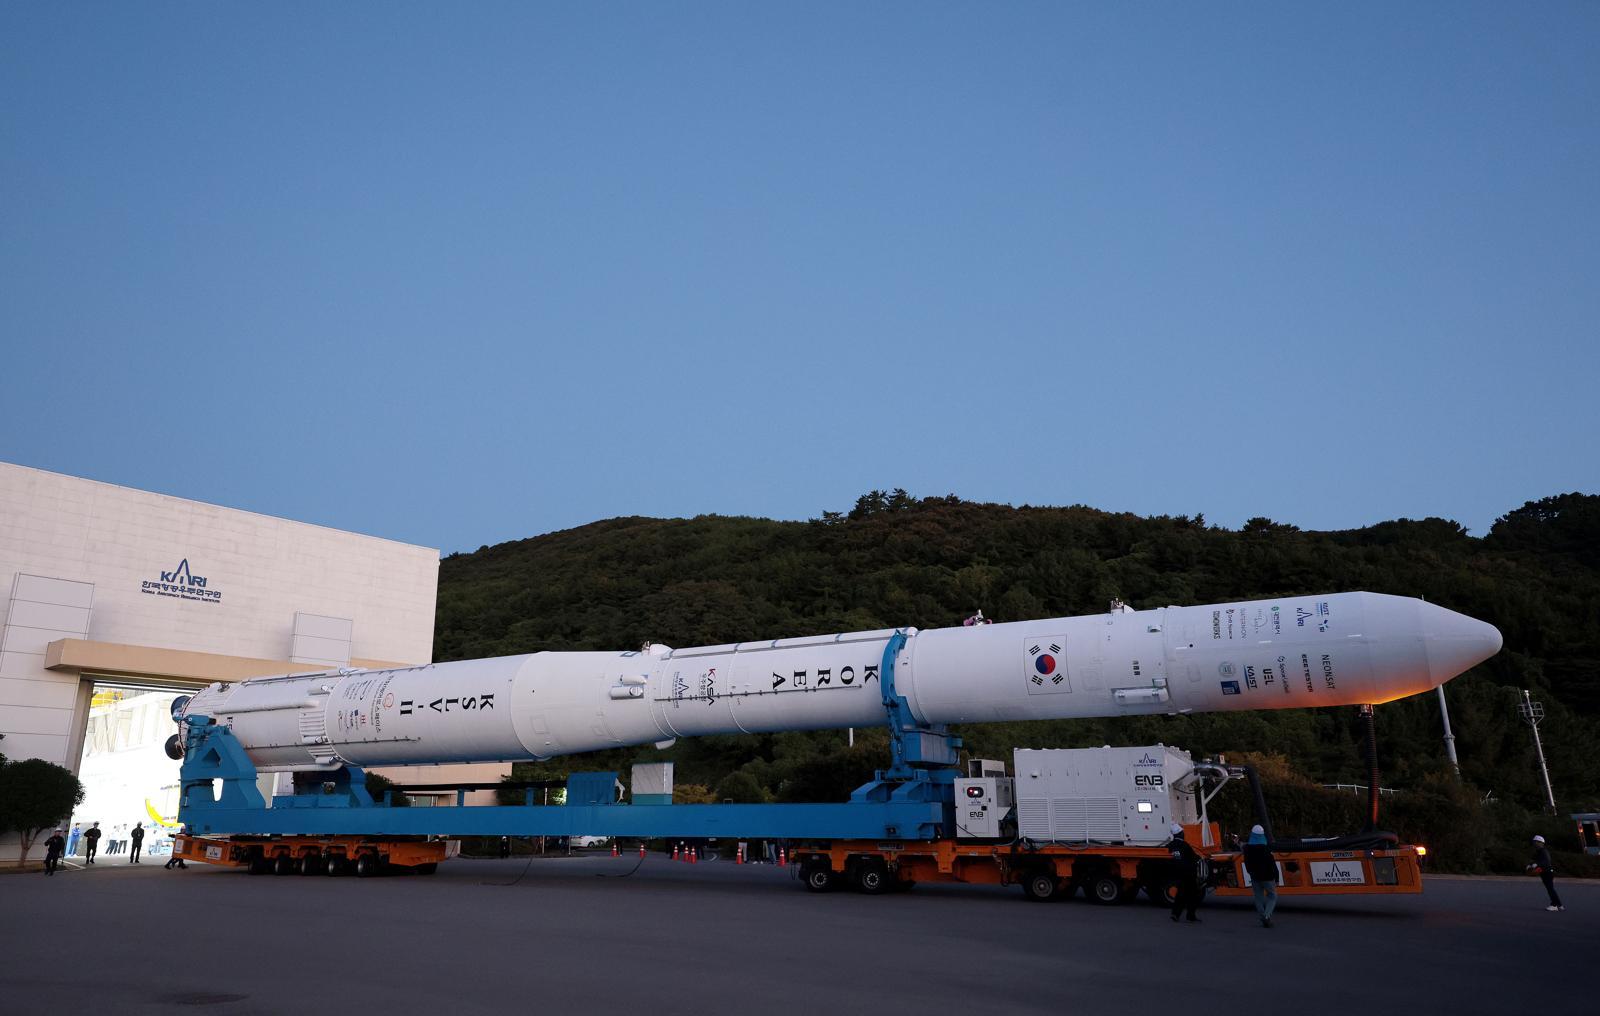
발사대에 우뚝 선 누리호…막바지 준비 거쳐 내일 우주로
3 weeks ago
353
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
