 2 weeks ago
21
Generate an SVG of a pelican riding a bicycle 프롬프트로 생성한 그림들의 유사성은 LLM의 다양성 붕괴를 보여줌 Design Creativity Bench는 UI 디자인에서도 이 문제를 평가하며, 기능적인 웹사이트와 제품 UI 생성 능력은 발전했지만 창의적인 디자인 결정에는 어려움이 남아 있다고 봄 평가는 프런티어 모델 16개를 대상으로 개방형 UI 과제 80개를 각각 서로 다른 두 제품 도메인에 적용하고, 인간 디자이너의 참조 결과와 비교함 디자인 창의성을 독창성, 창의적 범위, 적합성으로 나눠, 다른 모델과의 차별성부터 도메인 변화에 대한 대응과 기능 요구사항 충족까지 측정함 종합 창의성 점수에서 최고 모델인 GPT-6 Astra는 65.5점, 인간 참조 결과는 92.3점으로 상당한 격차가 나타남 펠리컨 SVG와 다양성 붕괴 동일한 자전거 타는 펠리컨 SVG 생성 프롬프트의 결과들을 다른 예시들과 대비하면, 충분히 논의되지 않는 LLM 다양성 붕괴 문제가 드러남 비교에 사용한 원본 SVG는 Simon Willison의 실행 결과에서 가져왔으며, SVG를 반환한 가장 높은 추론 설정을 사용함 UI 디자인 창의성 벤치마크 Design Creativity Bench는 LLM 창의성 연구의 일환으로 UI 디자인의 다양성 붕괴를 평가함 프런티어 모델 16개에 개방형 UI 과제 80개를 주고, 각 과제를 두 가지 제품 도메인에 맞춰 평가함 인간 디자이너의 참조 결과도 비교에 사용함 기존 UI 벤치마크가 흔히 단일 출력 품질 지표를 측정하는 것과 달리, 세 가지 창의성 차원을 측정함 독창성(Originality): 같은 요구사항에 대한 디자인이 다른 모델의 출력과 얼마나 구별되는지 평가함 창의적 범위(Creative Range): 제품 도메인이 바뀔 때 디자인 결정을 얼마나 조정하는지 평가함 적합성(Appropriateness): 생성한 UI가 요구사항의 기능적 조건을 얼마나 충족하는지 평가함 종합 창의성 점수는 인간 참조 결과 92.3점, GPT-6 Astra 65.5점으로 최고 모델도 인간과 상당한 격차를 보임 공개된 표에는 GPT-6.1 Sol 63.7점, Grok 4.7 62.2점, Gemini 3.8 Flash 60.6점도 포함됨 디자인 창의성을 모델 역량의 측정 가능한 차원으로 삼기 위해 전체 순위표, 방법론, 재현 가능한 평가 프레임워크를 공개함 벤치마크 순위표 연구 논문...
Related

국가 슈퍼컴퓨터 ‘한강’, GPU 8,496개 탑재해 12월 14일 정식 서비스 시작
2 hours ago
2
2026년 머신러닝을 배우는 방법
2 hours ago
1
에이전트와 함께 개발하기 위한 실용 원칙
2 hours ago
1
SEC는 대중을 보호하기 위해 Anthropic의 IPO를 막아야 함
2 hours ago
1
Anthropic의 성장세가 정체되기 시작함
3 hours ago
1
DNS 빌드 지연을 절반으로 줄이고 메모리 사용량을 85% 절감한 방법
3 hours ago
2
Oracle, AI 인프라 확충 위해 약 26조원 규모 신주와 채권 발행 계획 제출
3 hours ago
5
Show GN: 치이카와 닮은꼴 찾기
3 hours ago
2
Popular

승부 가리기엔 11회가 모자랐다…KT, 연장 접전 끝 롯데와 2-2 무승부→매직넘버 2
4 weeks ago
493

“군대 안가” 자랑한 축구대표팀에…안철수 “군대가 혐오시설? 군면제 없애야”
4 weeks ago
486

[ET특징주]펩트론, 일라이릴리 기술평가 종료 소식에 하락세
3 weeks ago
485

[美특징주]캠벨·제너럴밀스 등 강세…기술주 이탈해 소비재주로
2 weeks ago
482

은행권 AI 연쇄해킹…공격서버에 ‘중국어 문자열’ 있었다는데
4 weeks ago
480
이효리, 잔고 10만원·찬물 샤워 '쉬었음 청년' 커플 사연에.."너무 마음 아파"[연애전쟁]
4 weeks ago
381
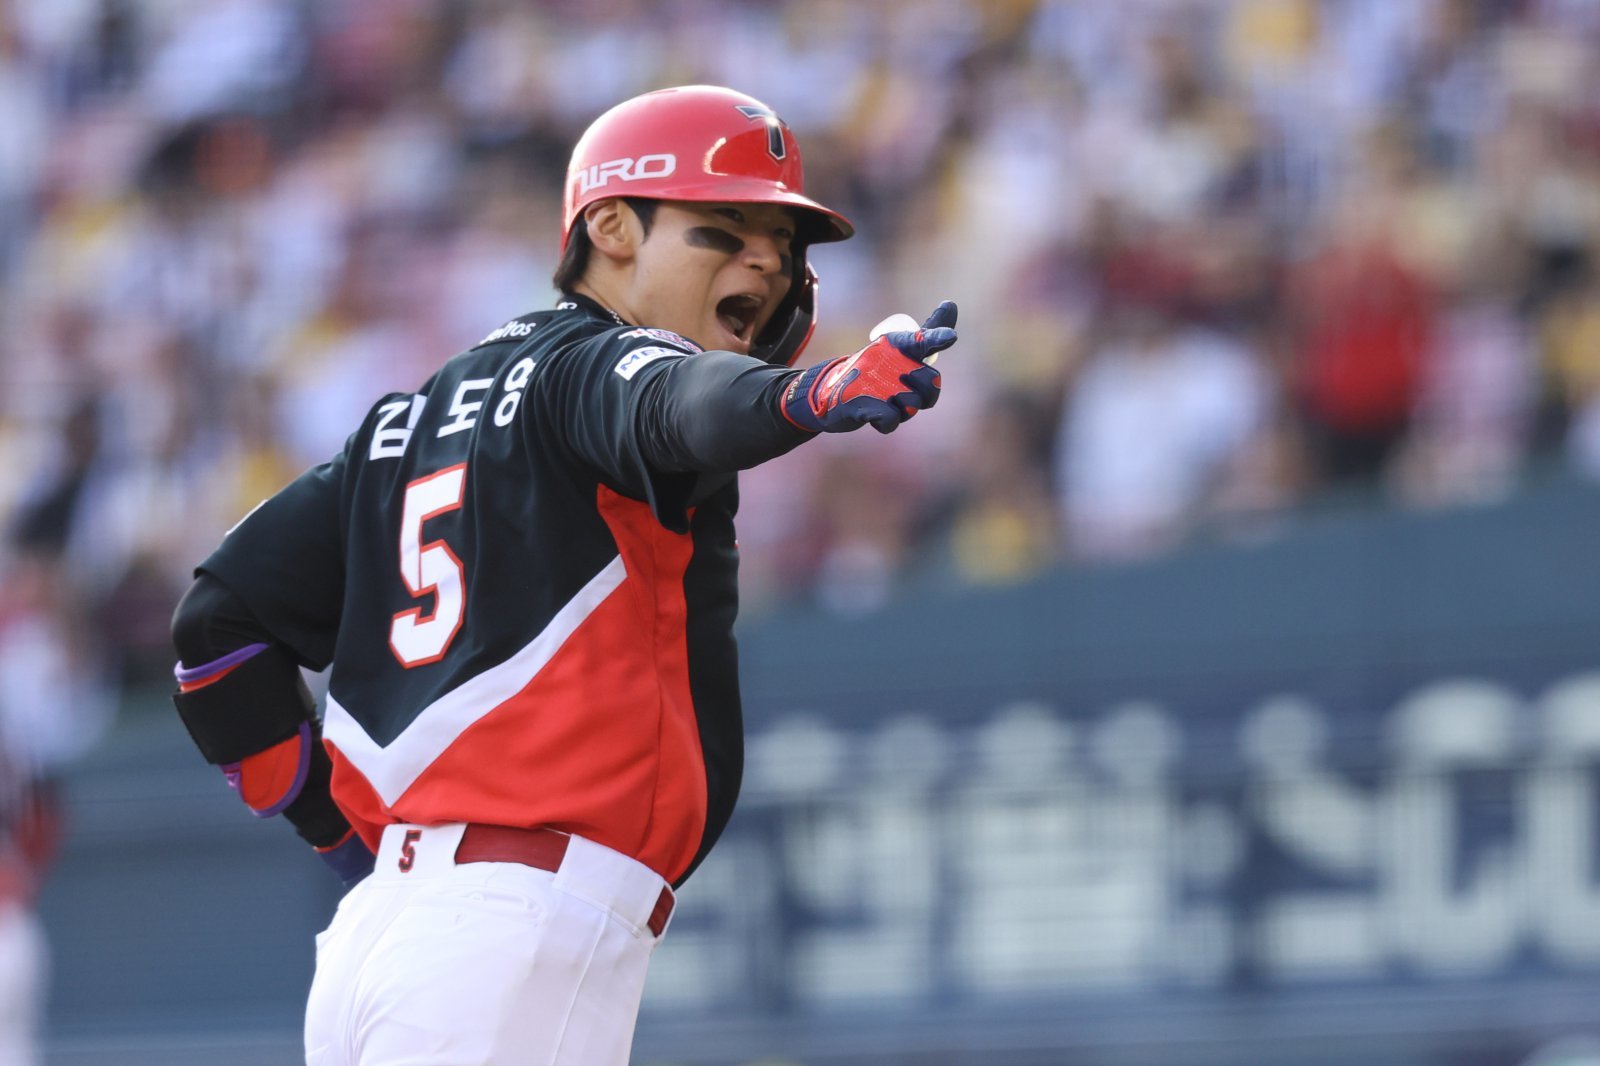
“왜 슈퍼스타인지 증명했다” 김도영, 9회초 역전 스리런포 작렬…KIA 3위 자리 지켰다
4 weeks ago
379
존슨앤존슨, 켄뷰 분사로 혁신 의약품 집중…목표가 상향-씨티
4 weeks ago
368
[美특징주]레나, 버크셔해서웨이가 지분 매입 소식에 상승
3 weeks ago
366
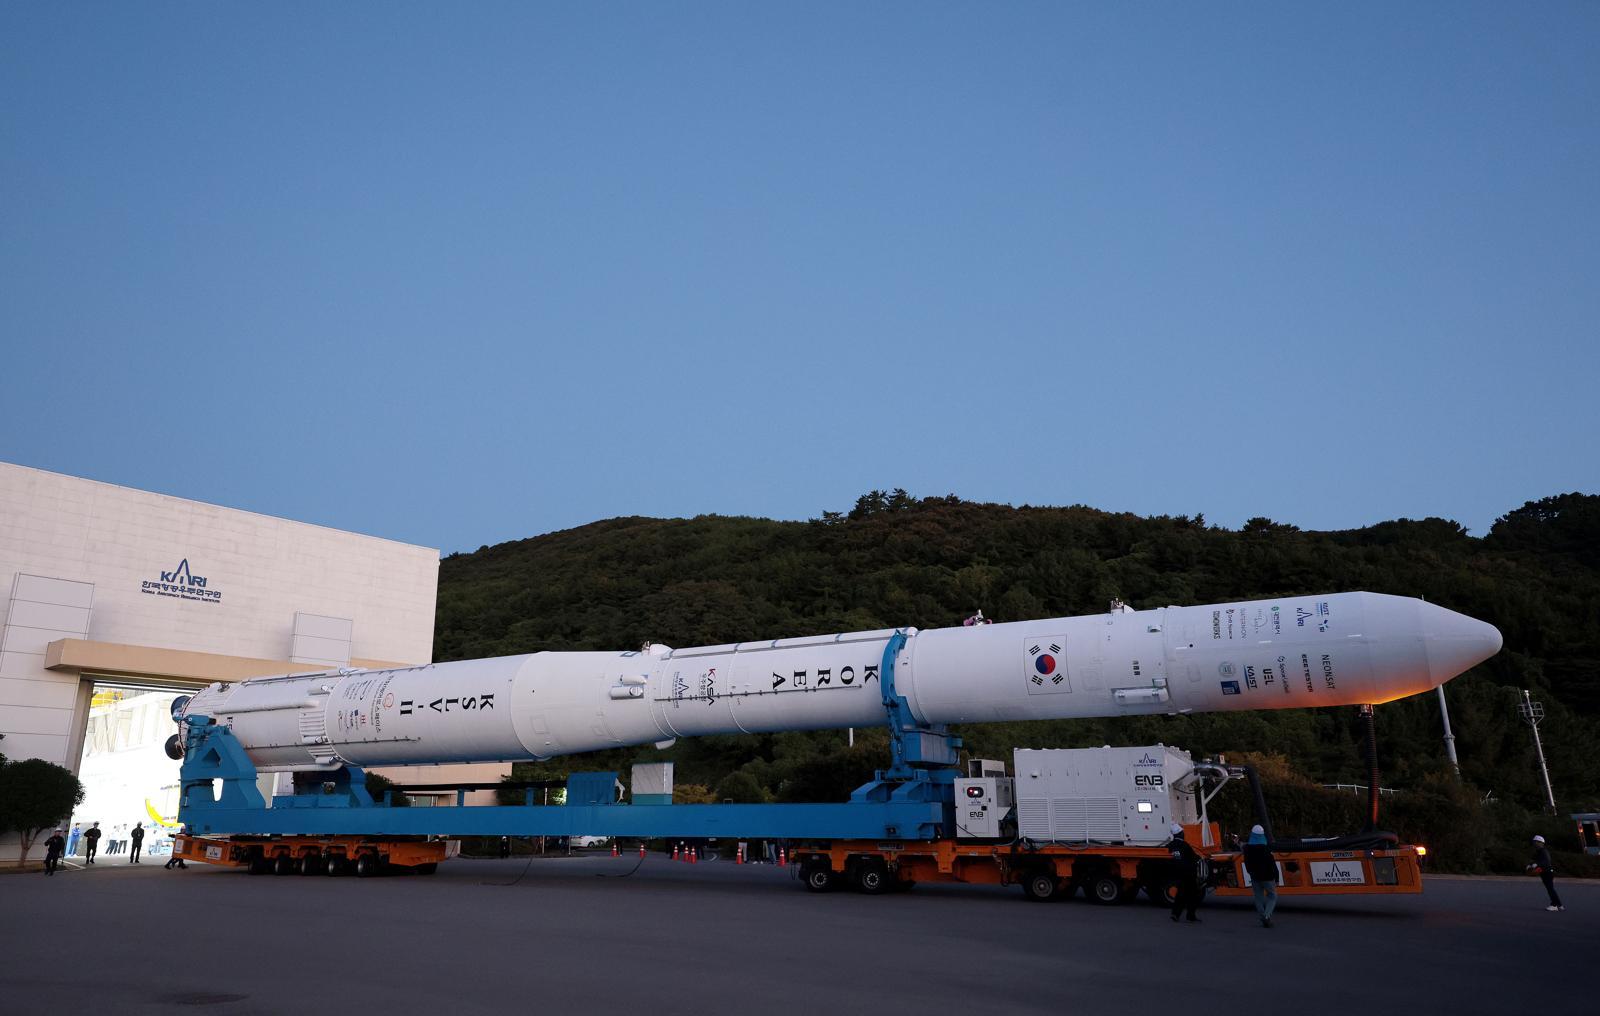
발사대에 우뚝 선 누리호…막바지 준비 거쳐 내일 우주로
4 weeks ago
355
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
