 2 hours ago
1
PrismML이 Qwen3.8 27B 기반의 3진 가중치 모델을 공개함. 전체 정밀도 모델보다 크기를 9배 이상 줄였으며, 종합 벤치마크 성능 98.2% 를 유지 가중치를 −1, 0, +1 세 값과 보정용 배율로 표현해 가중치당 실효 비트 수를 1.76비트로 낮춤 종합 83.9점으로 코딩과 수학 성능은 원본에 근접하고 지시 따르기는 이를 웃돌며, 이전 Bonsai 세대보다 추론과 비전, 장기 에이전트 작업 성능도 개선함 자체 측정 처리량은 RTX 5090에서 최대 143토큰/초, M5 Max에서 46.8토큰/초이며, 로컬 코딩 에이전트와 컴퓨터 사용 데모를 공개. 에너지 효율이 40% 높음 262K 토큰 컨텍스트와 텍스트/이미지 입력을 지원하고, CUDA와 MLX용 전용 저비트 커널로 실행하며 가중치는 Apache-2.0 라이선스로 공개 압축 방식과 이전 세대 대비 변화 Ternary Bonsai 2 27B는 두 달 전 공개한 첫 Bonsai 27B의 후속 모델로, 기반 모델을 Qwen3.8 27B로 변경함 추론, 코딩, 비전, 장기 에이전트 작업 성능을 개선하면서 작은 메모리 사용량, 높은 로컬 처리량, 에너지 효율을 유지함 전체 정밀도 모델 대비 성능 유지율은 이전 세대의 95%에서 98% 이상으로 높아짐 3진 가중치 {−1, 0, +1} 에 FP16 그룹별 스케일링을 결합하고, 저비트 표현을 언어 모델 전체에 적용함 가중치당 실효 비트 수는 1.76비트, 전체 모델 크기는 5.9GB임 크기는 전체 정밀도 모델의 9분의 1 미만이면서 종합 벤치마크 성능의 98.2%를 유지함 262K 토큰 컨텍스트 윈도와 멀티모달 텍스트/이미지 입력을 지원함 벤치마크 성능과 로컬 활용 사고 모드(thinking mode) 기준 종합 점수는 Ternary Bonsai 2 27B가 83.9점, Qwen3.8 27B가 85.4점, Qwen3.6 27B가 83.6점임 영역별 점수는 아래와 같으며, 수치는 Bonsai 2 / Qwen3.8 / Qwen3.6 순서임 에이전트 및 도구 호출: τ²-bench, BFCLv3에서 77.57 / 79.74 / 80.05점임 코딩: HumanEval+, LiveCodeBench v6, MBPP+, BigCodeBench에서 81.58 / 82.17 / 82.57점임 지시 따르기: IFBench, IFEval에서 82.66 / 81.25 / 74.53점임 지식 및 추론: MMLU-Redux, GP...
Related

macOS 27 Golden Gate 리뷰
1 hour ago
0
스타트업을 피벗해야 할까? [동영상]
1 hour ago
1
SpaceXAI가 한 달 만에 Grok Bot을 만든 방법 [동영상]
2 hours ago
0
Anthropic, AI가 AI를 개발하는 내부 현황과 감독 지표 공개
2 hours ago
0
jcode - 수십 개 세션을 병렬로 실행하는 터미널 코딩 에이전트
2 hours ago
1
GitLab.com의 요청 속도 제한이 변경됨
3 hours ago
1
왁스 모터
4 hours ago
1
Bend - CPU와 GPU에서 증명으로 AI의 실수를 차단하는 언어
4 hours ago
1
Popular
[美특징주]월마트, 동일매장 매출 성장 둔화에 주가 10% 급락
4 weeks ago
69
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
3 weeks ago
60
한로로, 코르티스 ‘조롱 가사’ 논란 직접 등판…“좋은 뜻으로 받아들여”
3 weeks ago
57
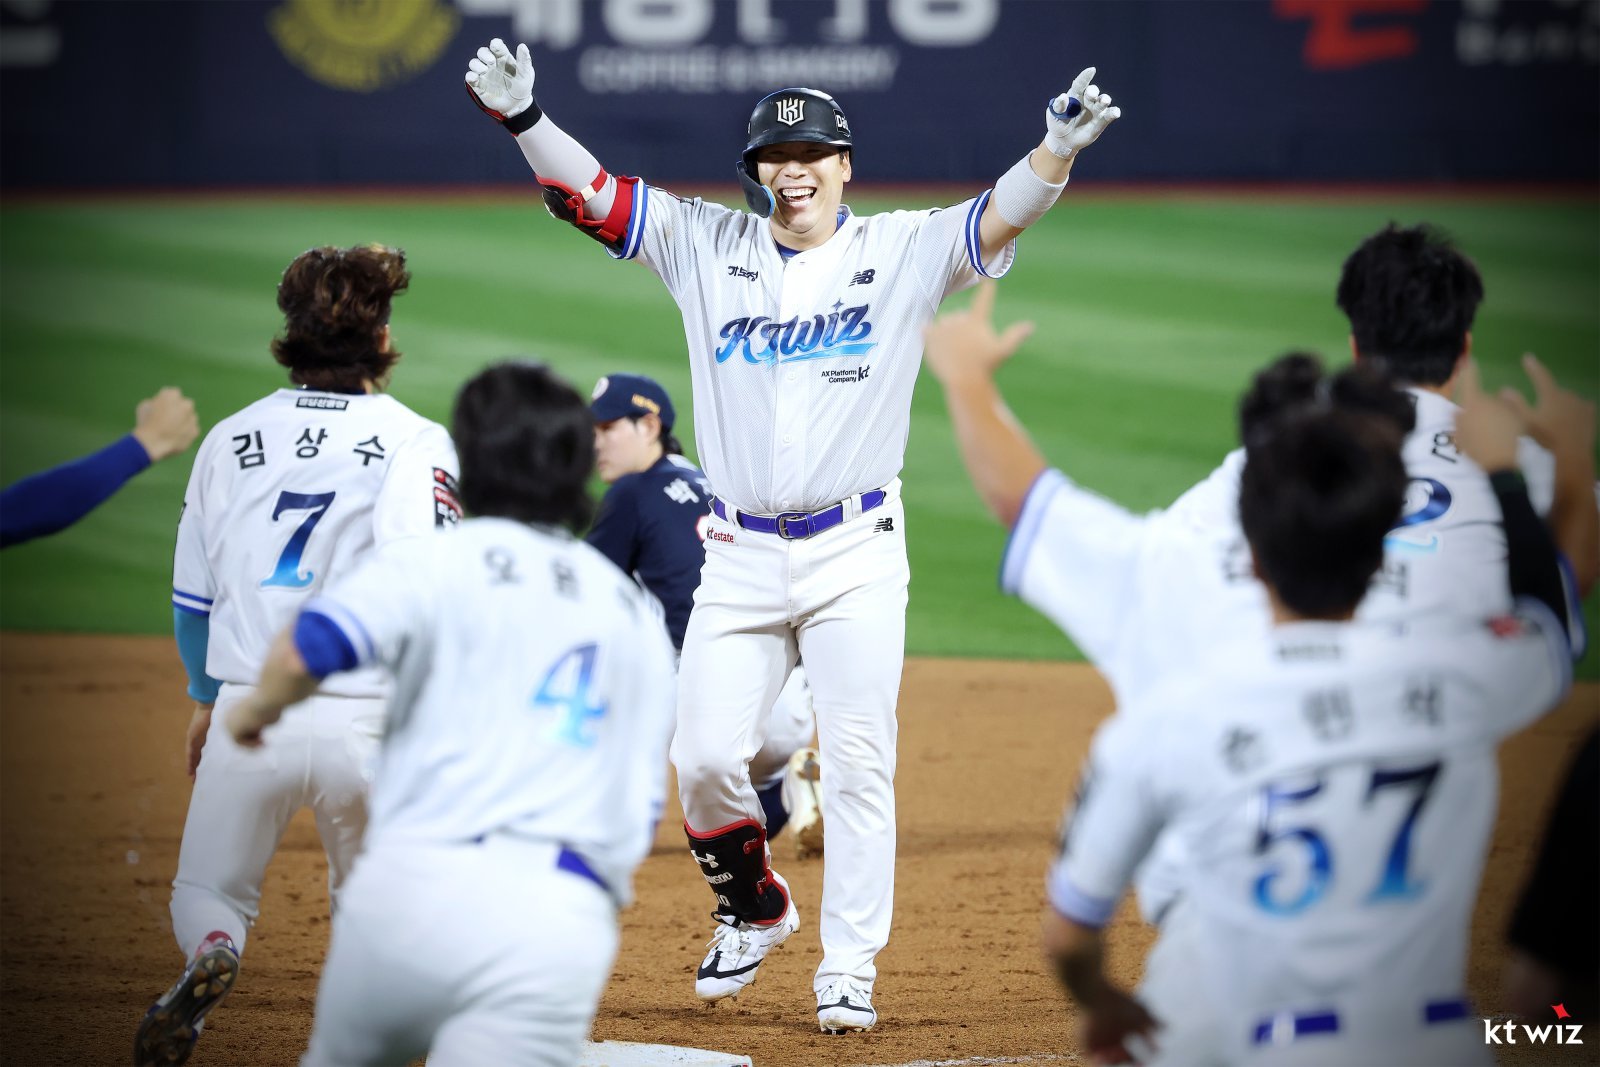
베테랑 김현수 끝내기안타…KT 선두 지켰다, 4년차 김정운은 데뷔 첫 승 감격 [SD 수원 스타]
3 weeks ago
56

“돌발적으로 저질렀다”…제자 물통에 소변 넣은 교사, 日 교육계 ‘발칵’
4 weeks ago
56
Qwen 3.8-Flash-Next(125B a6B), 2026년 8월 26일 공개 예정
3 weeks ago
53

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
2 weeks ago
52
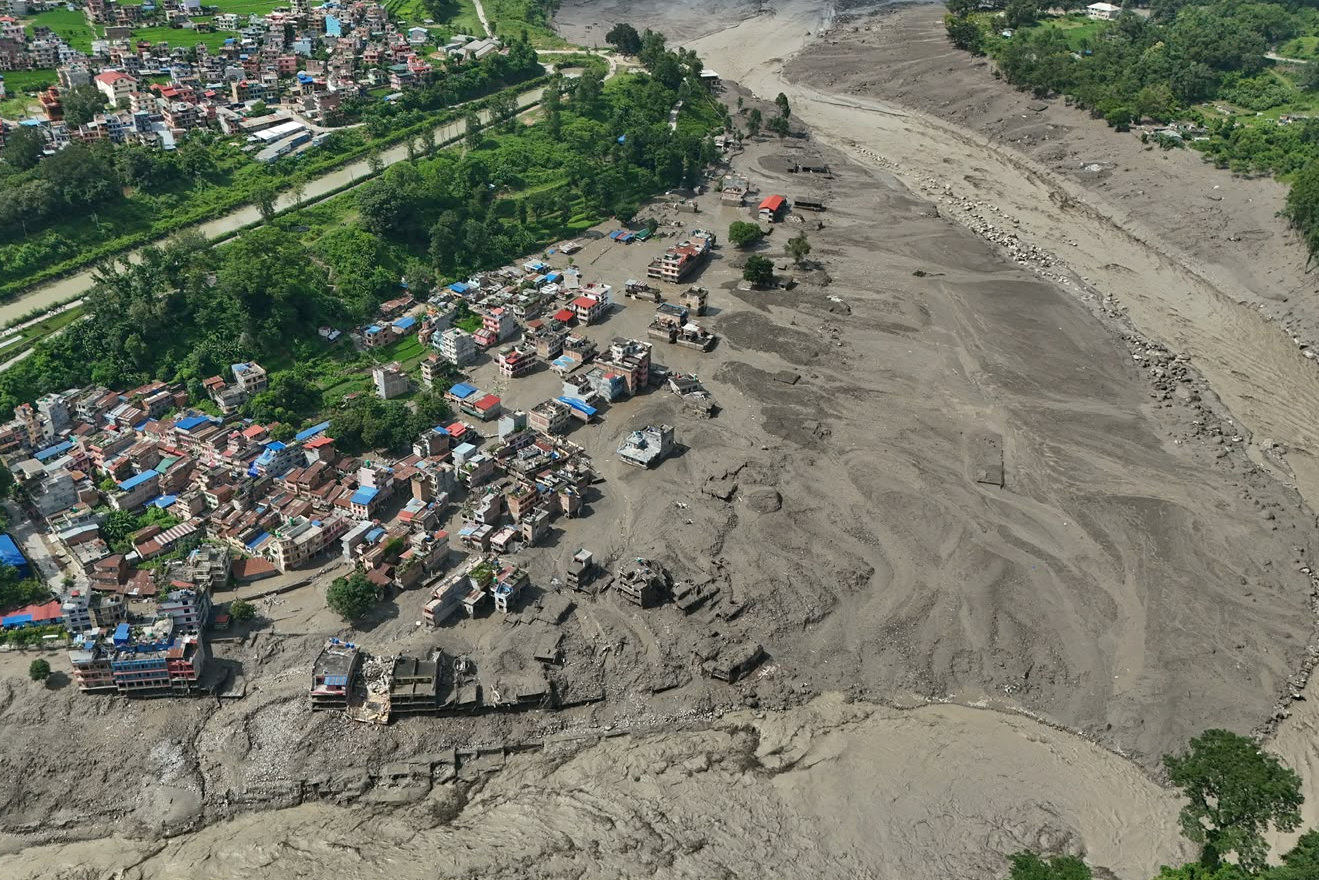
부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
3 weeks ago
52
에브리봇, 中 피지컬 AI 기업 엑스스퀘어와 MOU…휴머노이드 사업 확대
3 weeks ago
50

'AI 의약 플랫폼' 미라보 바이오, 프리 A 40억원 투자 유치[마켓인]
4 weeks ago
48
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
